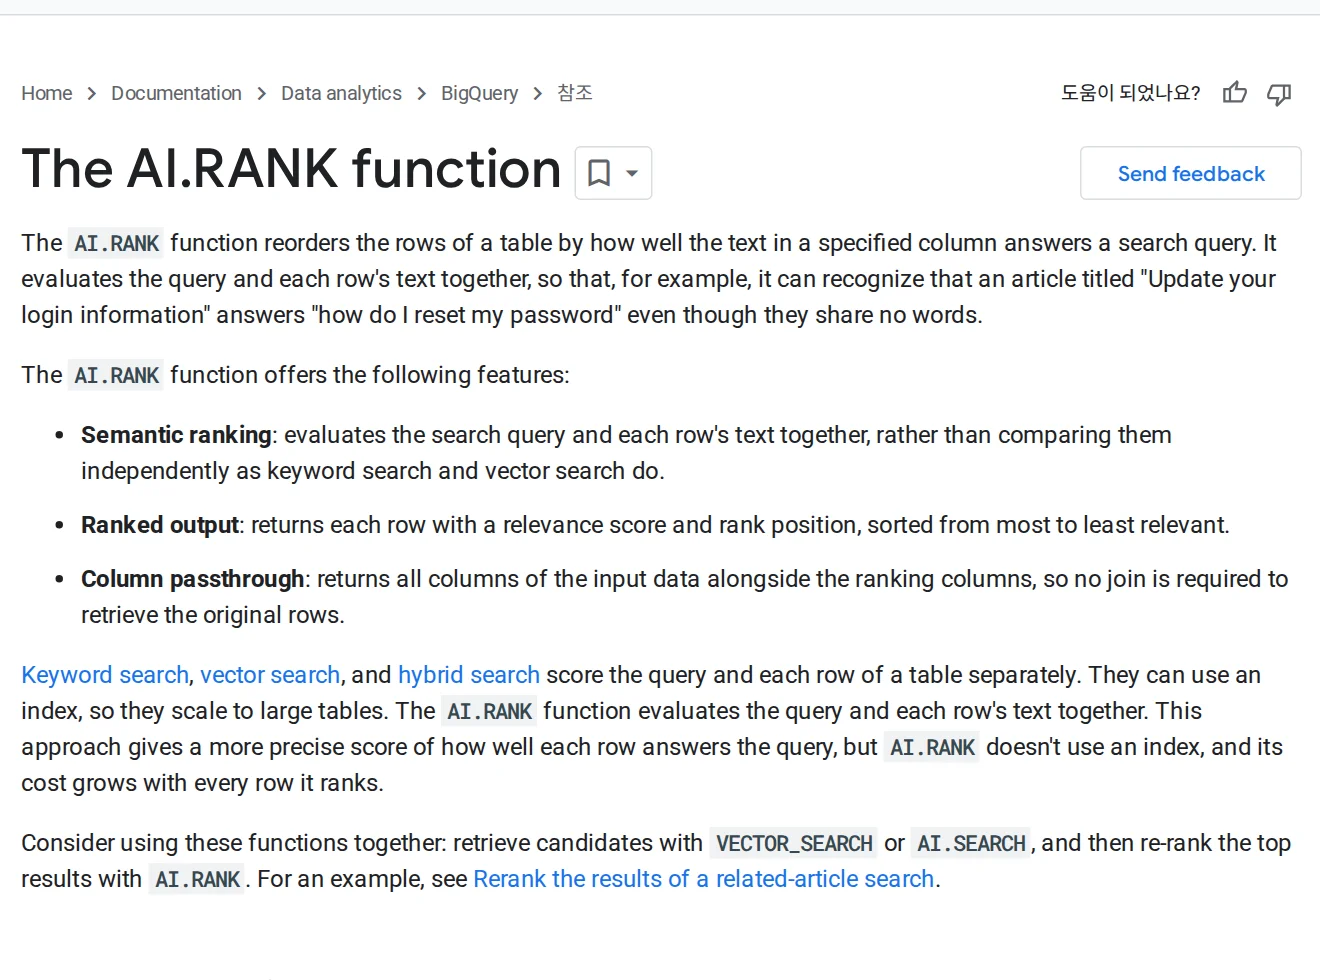
빅쿼리 AI.RANK는 표의 행을 "검색어에 얼마나 잘 답하는가" 기준으로 다시 줄 세우는 함수다. 구글 클라우드는 11월 17일자 빅쿼리 릴리스 노트에서 이 함수가 정식 출시(GA)됐다고 밝혔다. 리뷰·문의·문서 제목이 쌓인 표에서 "비밀번호 재설정 방법"을 물으면, 단어가 하나도 겹치지 않는 "로그인 정보 변경하기" 행도 위로 올려 주는 식이다.
AI.RANK는 지정한 텍스트 컬럼이 검색어에 얼마나 잘 답하는지를 0.0~1.0 점수와 순위로 돌려주고, 원래 컬럼을 그대로 붙여 준다.
인덱스를 쓰지 않아 받은 행마다 비용이 늘기 때문에, 공식 문서는 벡터 검색으로 후보를 먼저 줄인 뒤 AI.RANK로 다시 정렬하라고 권한다.
쓰려면 프로젝트에서 Discovery Engine API를 켜고, 쿼리 실행 계정에 Discovery Engine Viewer 역할을 줘야 한다. 요금은 별도의 랭킹 API 가격으로 청구된다.
빅쿼리 AI.RANK와 키워드·벡터 검색의 차이
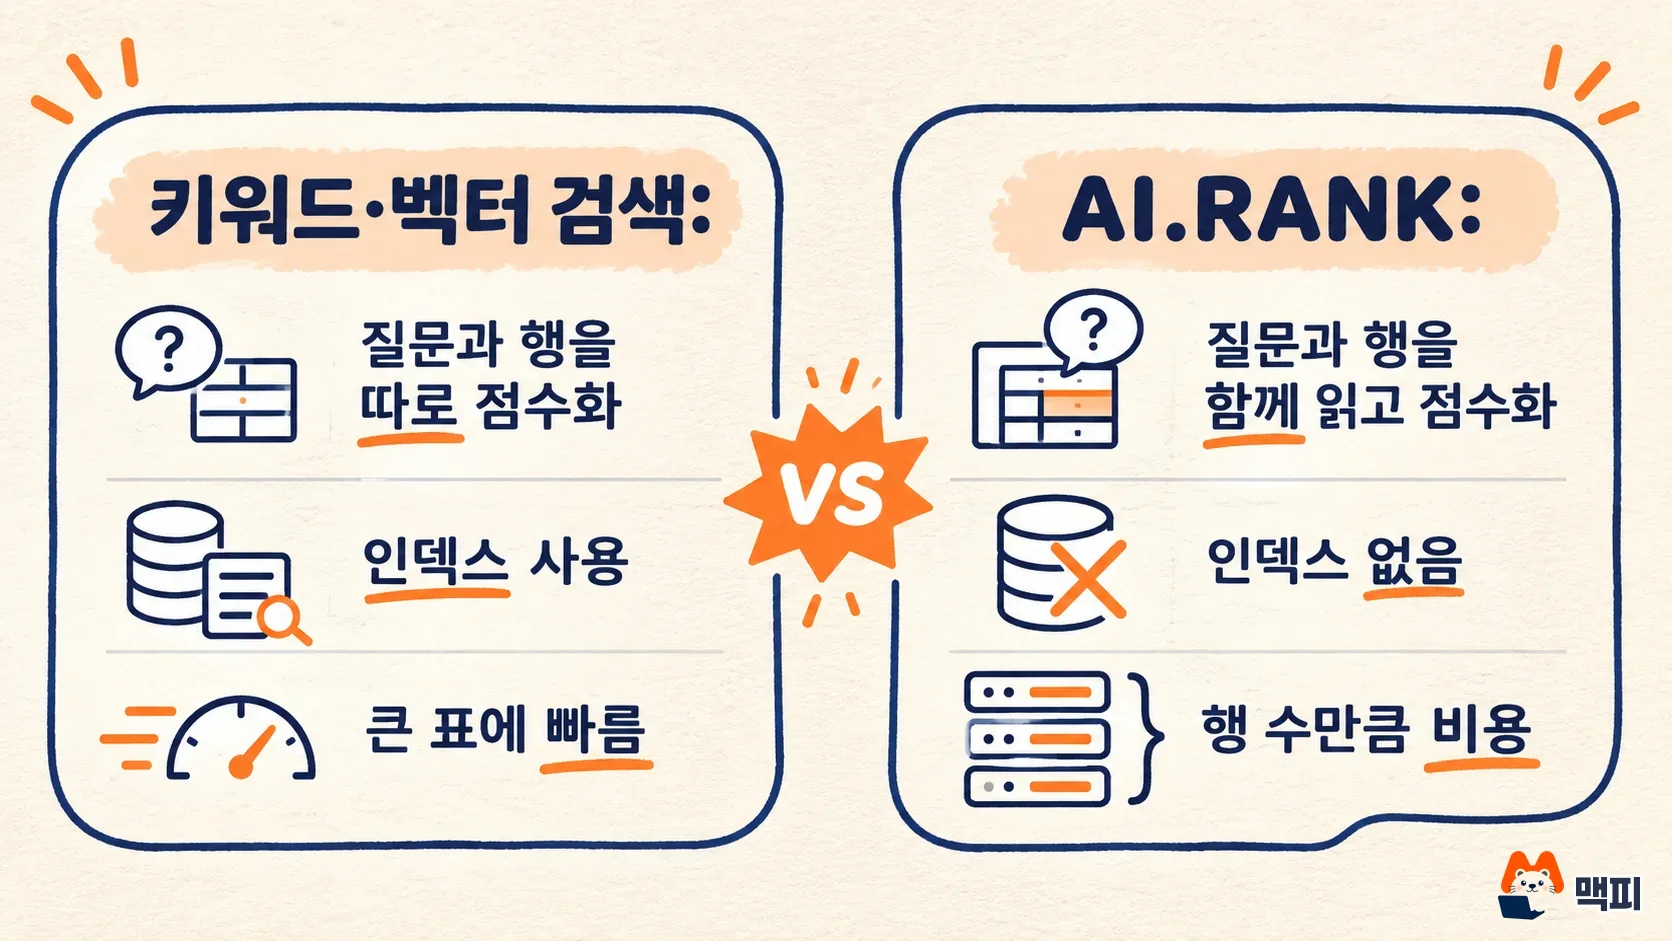
AI.RANK는 검색어와 각 행의 텍스트를 함께 읽고 점수를 매긴다. 구글 공식 문서에 따르면 키워드 검색, 벡터 검색, 하이브리드 검색은 검색어와 각 행을 따로 점수화하는 방식이어서 인덱스를 쓸 수 있고 큰 표에서도 빠르다. 대신 AI.RANK는 더 정밀한 점수를 주는 만큼 인덱스를 쓰지 못하고, 비용이 순위를 매기는 행 수에 비례해 늘어난다(AI.RANK 레퍼런스).
| 구분 | 점수를 매기는 방식 | 인덱스 | 비용과 규모 |
|---|---|---|---|
| 키워드·벡터·하이브리드 검색 | 검색어와 각 행을 따로 점수화 | 사용 가능 | 큰 표에서도 확장된다 |
| AI.RANK | 검색어와 각 행의 텍스트를 함께 평가 | 사용 안 함 | 순위를 매기는 행마다 비용이 는다 |
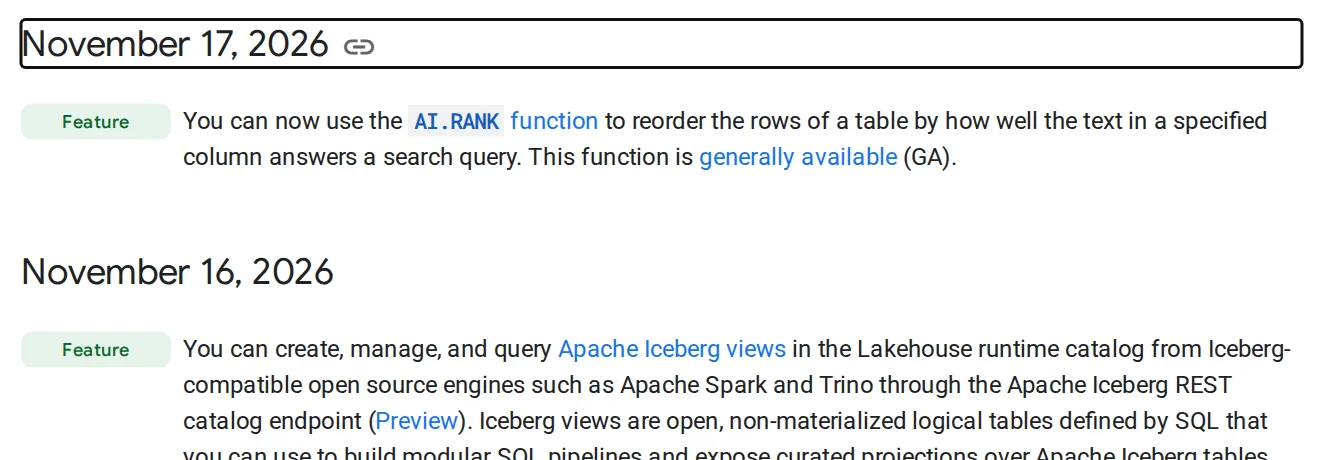
그래서 AI.RANK는 검색을 대체하기보다 검색 결과의 2단계로 쓰는 함수다. 릴리스 노트 항목을 보면 이 한 줄이 전부다. "텍스트 컬럼이 검색어에 얼마나 잘 답하는지로 행을 재정렬한다"는 것과 정식 출시라는 것이다.
AI.RANK 쿼리 쓰는 법: 구문과 첫 예제
AI.RANK는 데이터, 순위를 매길 컬럼, 검색어를 받는다. 모델과 반환 행 수는 선택이다.
| 인자 | 필수 | 설명 |
|---|---|---|
| TABLE 테이블명 또는 (쿼리문) | 필수 | 순위를 매길 데이터. 둘 중 하나만 준다 |
| column_to_rank | 필수 | 순위를 매길 텍스트 컬럼 이름. STRING 타입이어야 하고, 입력 데이터에 rank·score라는 이름의 컬럼(대소문자 무관)이 있으면 안 된다 |
| query | 필수 | 비교할 검색어. 빈 문자열은 안 된다 |
| model | 선택 | 랭킹 모델. 생략하면 semantic-ranker-default@latest |
| top_n | 선택 | 돌려줄 최대 행 수. 양수여야 하고, 생략하면 순위를 매긴 모든 행을 돌려준다 |
공식 문서의 첫 예제는 BBC 뉴스 공개 테이블에서 주택 시장 하락에 가장 잘 맞는 제목 5개를 뽑는다.
SELECT rank, score, title
FROM AI.RANK(
  TABLE `bigquery-public-data.bbc_news.fulltext`,
  'title',
  'downward trends in the housing market',
  top_n => 5
);
결과에는 입력 컬럼에 rank(1부터 시작하는 순위, INT64)와 score(0.0~1.0 관련도, FLOAT64)가 붙고 rank 오름차순으로 정렬된다. 공식 문서가 보여 주는 결과는 아래와 비슷하며, 점수는 실행마다 달라진다.
| rank | score | title |
|---|---|---|
| 1 | 0.6353 | House prices drop as sales slow |
| 2 | 0.4060 | House prices suffer festive fall |
| 3 | 0.3988 | Survey confirms property slowdown |
| 4 | 0.3728 | UK house prices dip in November |
| 5 | 0.2671 | No seasonal lift for house market |
같은 구문을 리뷰 표에 옮기면 AI.RANK(TABLE `프로젝트.데이터세트.reviews`, 'review_text', '배송이 늦어서 불만인 리뷰', top_n => 20)처럼 쓴다. 공식 문서가 설명하는 동작은 단어가 겹치지 않아도 질문에 답하는 텍스트를 위로 올리는 것이므로, 어떤 리뷰가 올라오는지는 자기 표에서 결과를 열어 봐야 알 수 있다.
어느 컬럼에 AI.RANK를 걸어야 하나: 제목과 본문
공식 문서의 기준은 이렇다. 검색어가 주제를 말하면 제목이나 요약처럼 짧은 컬럼이 낫다. 긴 본문은 주제를 관련 없는 문단에 흩뜨리기 때문이다. 반대로 검색어가 헤드라인에 안 나올 세부 사항이면 긴 컬럼을 골라야 한다. 문서는 "회계 스캔들 뒤 사임한 임원"을 찾는 예로, 제목에 걸면 에어링구스 임원 사임 기사를 놓치고 본문에 걸면 찾는다고 설명한다.
특정 범주만 대상으로 할 때는 테이블 대신 쿼리문을 넘긴다. 아래 쿼리는 비즈니스 기사만 골라 본문 기준으로 3개를 뽑는다.
SELECT rank, score, title
FROM AI.RANK(
  (
    SELECT title, body
    FROM `bigquery-public-data.bbc_news.fulltext`
    WHERE category = 'business'
  ),
  'body',
  'executives who resigned after an accounting scandal',
  top_n => 3
);
AI.RANK는 받은 행을 전부 순위에 올리므로, WHERE로 먼저 줄이는 것이 비용을 통제하는 가장 쉬운 방법이다. 공식 문서도 이 방법을 권한다.
후보 50개를 추린 뒤 AI.RANK로 재정렬하는 2단계 검색
표가 크면 AI.RANK를 처음부터 걸지 않는다. 문서가 가장 유용하다고 소개하는 구조는 싼 단계가 후보를 고르고 AI.RANK가 후보만 재정렬하는 2단계 검색이다.
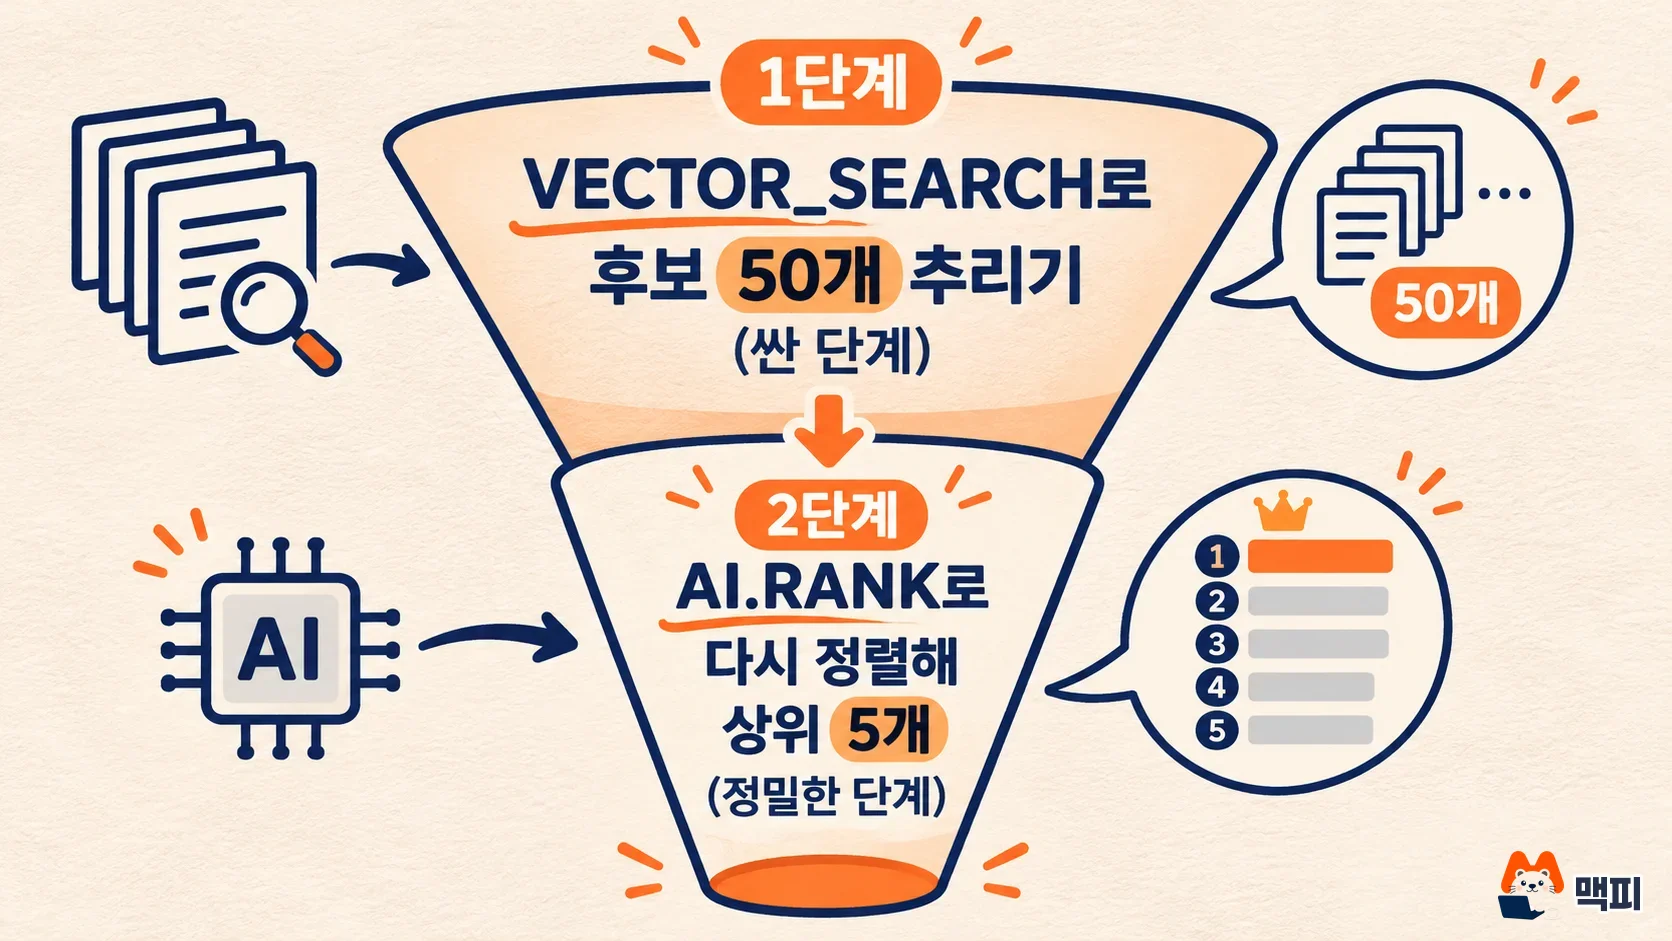
공식 예제는 임베딩(글을 숫자 벡터로 바꾼 값)이 미리 들어 있는 컬럼으로 VECTOR_SEARCH를 돌려 비슷한 기사 50개를 뽑고, 그 50개를 AI.RANK가 질문 기준으로 다시 정렬해 5개를 돌려준다.
SELECT rank, score, title
FROM AI.RANK(
  (
    SELECT base.title AS title, base.body AS body
    FROM VECTOR_SEARCH(
      TABLE `bigquery-public-data.bbc_news.fulltext`,
      'body_embedded',
      (
        SELECT body_embedded
        FROM `bigquery-public-data.bbc_news.fulltext`
        WHERE title = 'Bank opts to leave rates on hold'
      ),
      top_k => 50)
  ),
  'body',
  'downward trends in the housing market',
  top_n => 5
);
VECTOR_SEARCH는 텍스트가 아니라 벡터를 비교하므로 서브쿼리가 기존 기사의 임베딩을 넘긴다. 자기가 쓴 문장으로 찾으려면 AI.EMBED로 그 문장의 임베딩을 만들어 넘기면 된다. 이 구조에서 AI.RANK가 순위를 매기는 행은 50개뿐이라 쿼리가 빠르고 비용도 후보 수에 묶인다. 후보 추리기에는 AI.SEARCH도 쓸 수 있다. 결과 행들을 한 문단으로 요약하고 싶다면 빅쿼리 AI.AGG 함수 사용법을 이어서 본다. AI.RANK는 STRING 컬럼만 받으므로, 이미지나 PDF를 SQL에 넘기려면 빅쿼리 ObjectRef 사용법의 방식을 쓴다.
AI.RANK 쓰기 전 준비: API, 권한, 요금
AI.RANK는 쿼리를 실행한 프로젝트의 Agent Search 랭킹 API를 호출한다. 그래서 두 가지를 먼저 갖춰야 한다.
- 프로젝트에서 Discovery Engine API를 켠다. 켜려면
serviceusage.services.enable권한이 필요하고, 프로젝트를 직접 만들었다면 소유자 역할로 이 권한을 이미 가졌을 가능성이 크다. - 쿼리를 실행하는 계정에 프로젝트 수준의 Discovery Engine Viewer(
roles/discoveryengine.viewer) 역할을 준다. 이 역할에 AI.RANK 호출에 필요한discoveryengine.rankingConfigs.rank권한이 들어 있다.
요금은 랭킹 API 가격으로 별도 청구되고, 호출량은 그 프로젝트의 Agent Search 할당량에 잡힌다. 문서에 적힌 비용 통제법은 입력을 먼저 줄이는 것 하나다. 행의 텍스트가 모델의 토큰 한도보다 길면 넘는 부분은 잘린다. 모델별 한도는 지원 모델 표에 있다.
AI.RANK 결과가 맞는지 확인하는 법
AI.RANK의 score는 한 번의 결과 안에서 행끼리 비교할 때만 쓰는 값이다. 검색어마다 보정되지 않아서 "score가 0.5보다 큰 행만"처럼 고정 기준을 걸면, 어떤 검색어에서는 괜찮아도 다른 검색어에서는 정답을 잘라 낸다. 0.0은 관련 없는 텍스트와 순위가 매겨지지 않은 행을 구분하지 못한다. 결과를 줄일 때는 top_n을 주거나 rank 컬럼으로 거른다.
자기 데이터에서 확인하는 순서는 다음과 같다.
- 행이 수백 개인 표나 WHERE로 줄인 쿼리로 시작해 비용을 묶는다.
- 이미 정답인 줄 아는 행 3~5개가 있는 검색어를 고르고
top_n => 10으로 실행한다. - 아는 행이 상위에 오르는지 rank로 본다. 점수 숫자가 아니라 순서를 본다.
- 안 오르면 같은 검색어로
column_to_rank를 제목에서 본문으로(또는 반대로) 바꿔 다시 돌린다.
쿼리가 오류 없이 끝나고 rank가 1부터 이어서 나오면 실행은 성공이다. 행 수가 입력보다 적어도 오류가 아니다. 문서에 따르면 순위 대상 컬럼이 NULL이거나 빈 문자열인 행은 순위를 매기기 전에 빠지고, top_n을 넘는 행도 결과에서 빠진다.
자주 묻는 질문
model 인자는 꼭 지정해야 하나요?
아니다. 생략하면 항상 최신 랭킹 모델을 가리키는 semantic-ranker-default@latest가 쓰이고, 공식 문서는 모델 개선이 자동으로 반영되도록 생략하기를 권한다.
AI.RANK 쿼리 요금은 어느 프로젝트에 청구되나요?
쿼리를 실행하는 프로젝트다. 공식 문서에 따르면 AI.RANK는 실행 계정의 자격으로 그 프로젝트의 Agent Search 랭킹 API를 호출하고, 사용량은 랭킹 API 가격으로 청구된다.
AI.RANK만 써서 표 전체를 검색해도 되나요?
작은 표나 WHERE로 줄인 결과에는 괜찮다. 큰 표 전체에는 인덱스를 못 쓰고 행마다 비용이 들기 때문에, VECTOR_SEARCH나 AI.SEARCH로 후보를 먼저 추리는 방식이 공식 문서의 권장 구조다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.