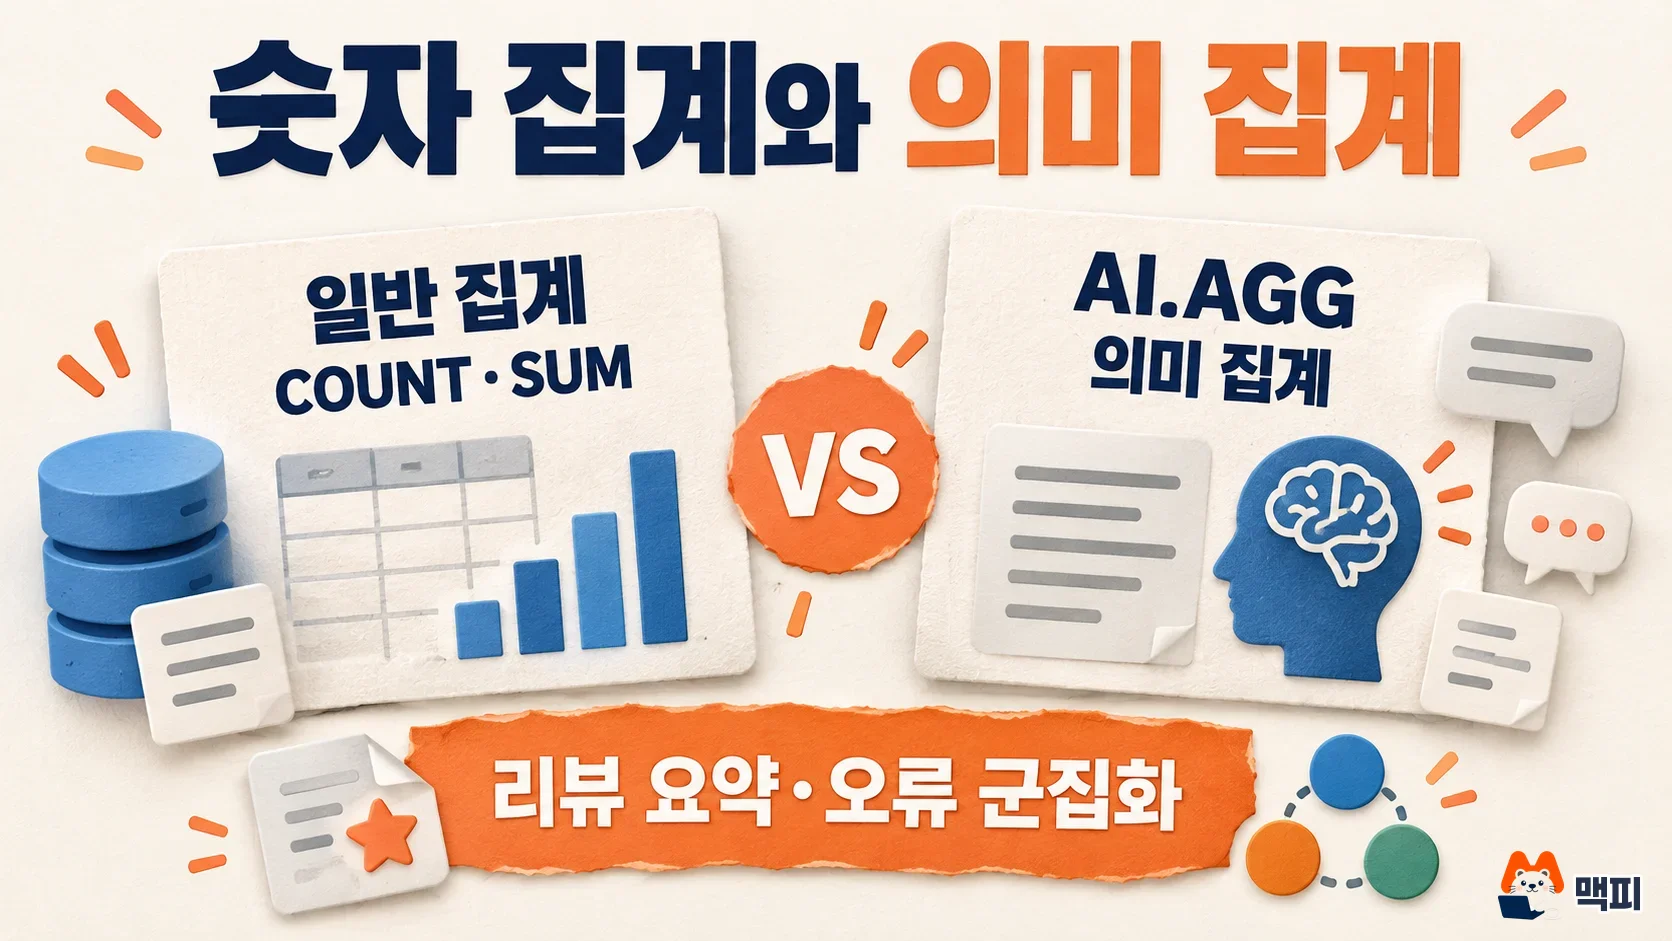
빅쿼리 AI.AGG는 자연어 지시문에 따라 여러 행의 텍스트나 이미지를 의미 기준으로 집계해 요약 결과 하나를 돌려주는 함수다. 구글 클라우드는 2026년 10월 13일 릴리스 노트에서 이 함수가 정식 출시(GA)됐다고 밝혔다(빅쿼리 릴리스 노트). COUNT나 SUM처럼 숫자를 세는 집계가 아니라, 리뷰 수천 건에서 "고객이 무엇을 불만으로 말하는가"를 한 문단으로 뽑는 용도다.
AI.AGG 함수가 하는 일
AI.AGG는 Vertex AI의 Gemini 모델을 호출해 입력 행을 자연어 지시문대로 집계하고 STRING 하나를 반환한다. 공식 문서가 권하는 사용처는 리뷰 감성 분석, 멀티모달 데이터 요약, AI 에이전트 성능 분석, 로그 분석, 오류 군집화다(AI.AGG 레퍼런스).
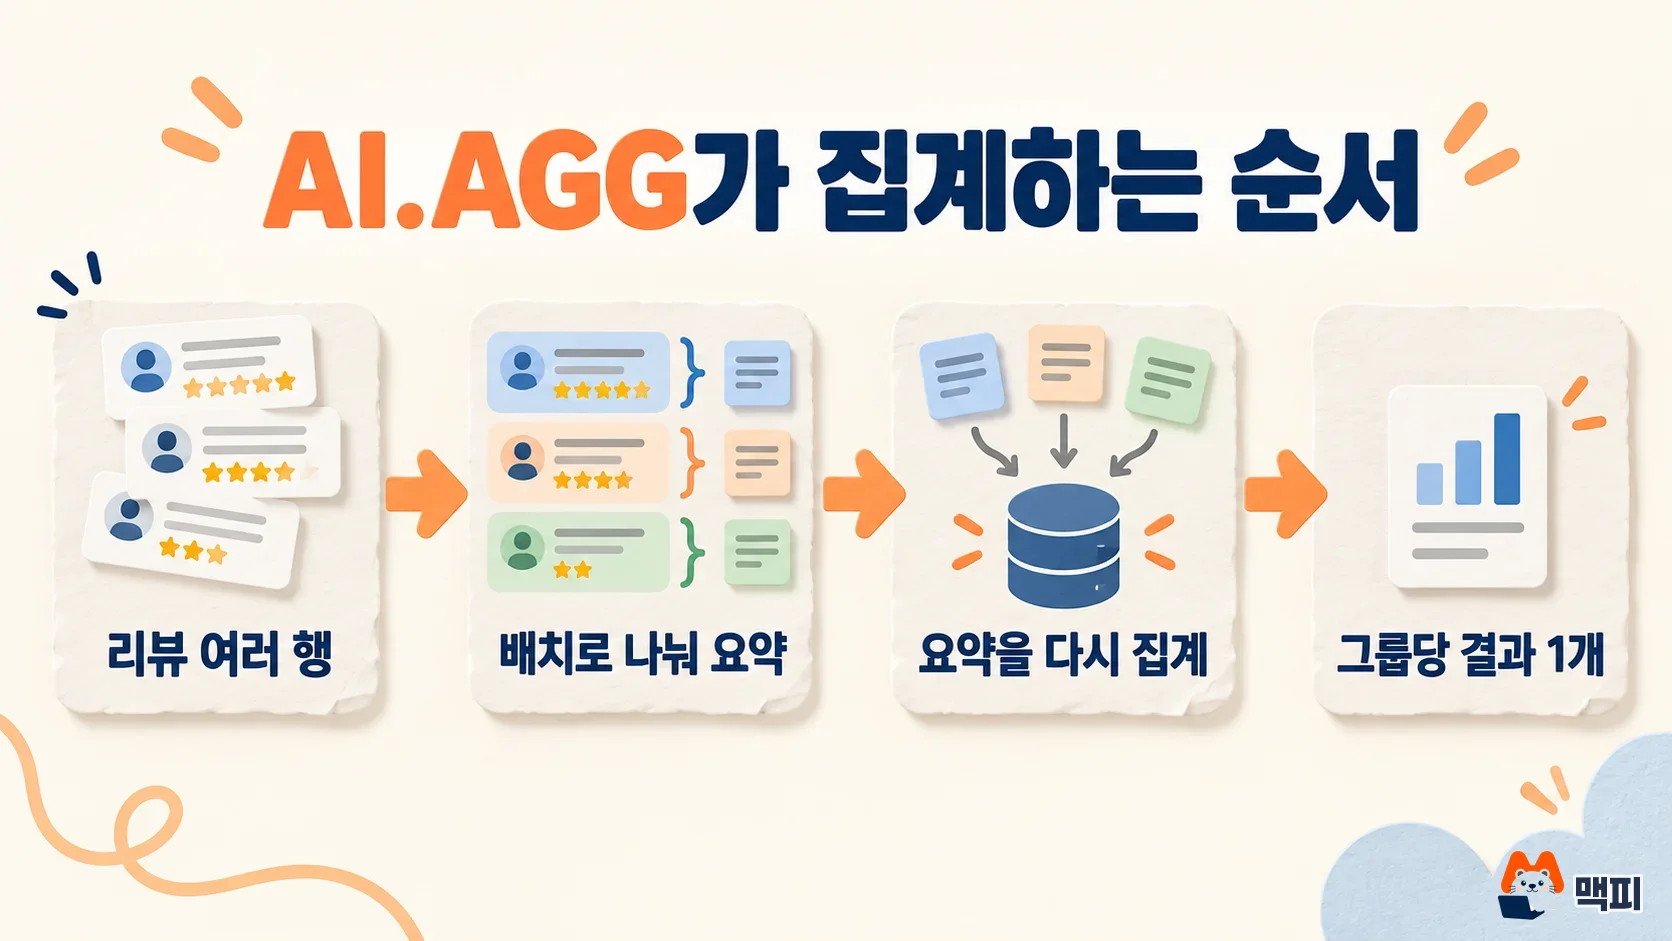
집계 작업에는 AI.GENERATE나 AI.GENERATE_TEXT 대신 AI.AGG를 권한다. 데이터를 배치로 나눠 요약한 뒤 그 결과를 다시 집계하는 다단계 처리를 자동으로 하므로 Gemini 컨텍스트 창보다 큰 데이터도 분석할 수 있고, 입력 그룹당 결과가 하나만 나오기 때문이다(AI.AGG 레퍼런스).
빅쿼리 AI.AGG 쿼리 쓰는 법
기본 구문은 입력 열과 지시문 두 개만 있으면 된다. 아래는 공식 예제로, 영화 리뷰를 영화별로 묶어 전체 감성을 요약한다.
SELECT
  title,
  movie_id,
  AI.AGG(
    review,
    'You will be given user-provided reviews of a movie. Summarize the overall sentiment towards the movie.'
  ) AS sentiment
FROM `bigquery-public-data.imdb.reviews`
WHERE movie_id IN ('tt0339384', 'tt0084787', 'tt0029850')
GROUP BY movie_id, title;
GROUP BY를 쓰면 그룹마다 요약이 하나씩 나오고, 생략하면 전체 행이 한 번에 집계된다. 선택 인자는 아래 표와 같다. 쿼리 초안부터 막힌다면 빅쿼리 SQL 편집기의 Gemini 버튼으로 주석을 SQL로 바꿔 시작할 수 있다.
| 인자 | 역할 |
|---|---|
| INPUT | 집계할 STRING 열, 또는 Cloud Storage 파일을 참조하는 값(이미지·동영상·오디오·텍스트·PDF) |
| INSTRUCTION | 집계 방식을 적은 자연어 지시문 |
| connection_id | Vertex AI와 Cloud Storage에 쓰는 Cloud 리소스 연결. 생략하면 사용자 자격 증명을 사용 |
| endpoint | 사용할 Gemini 모델. 생략하면 빅쿼리가 선택 |
| max_error_ratio | 행 단위 실패 허용 비율(0.0~1.0, 기본 1.0) |
| output_schema | 결과를 STRUCT로 받을 때의 필드 정의 |
결과 형식을 고정하고 싶으면 output_schema를 쓴다. 공식 문서는 필드 대부분에 NOT NULL을 붙이라고 안내한다. 붙이지 않으면 모델이 일부 필드를 NULL로 돌려줄 수 있다(AI.AGG 레퍼런스).
AI.AGG(
  t.text,
  'These are the hacker news blog posts of a single user. Tell me what topics the user talks about the most. Keep it concise.',
  output_schema => 'topics ARRAY<STRUCT<name STRING NOT NULL, explanation STRING NOT NULL>>'
)
AI.AGG 입력 한도와 실패 처리
문서가 권장하는 한도를 넘기면 쿼리가 실패하거나 일부 결과만 반환될 수 있다. 이미지는 행당 최대 10개, 오디오·동영상·PDF는 행당 파일 1개까지 넣을 수 있다.
| 입력 종류 | 쿼리당 권장 한도 |
|---|---|
| 텍스트·이미지 1개 행 | 2,000만 행 |
| PDF 행 | 10만 행 |
| 오디오 행 | 1만 행 |
| 동영상 행 | 1,000행 |
| 그룹 수 | 1,000개 이하 |
Vertex AI 호출이 쿼터 초과나 모델 사용 불가로 일부 실패하면 부분 결과가 돌아오고, 모든 호출이 실패하거나 실패 비율이 max_error_ratio를 넘으면 쿼리가 오류로 끝난다. 결과가 일부 빠져도 곤란한 분석이라면 max_error_ratio => 0.05처럼 낮춰 두는 편이 안전하다. 그룹당 출력은 최대 10,000 토큰으로 제한된다(AI.AGG 레퍼런스).
AI.AGG 비용과 쓰기 전 주의사항
공식 문서는 Gemini 추론을 비용이 상대적으로 큰 작업이라고 설명한다. 배치 처리와 재집계 때문에 Gemini로 가는 토큰 총량이 원본 데이터 토큰보다 많아지므로, 처음에는 WHERE나 LIMIT으로 행 수를 줄여 시험한다. 텍스트 입력의 토큰 수는 AI.COUNT_TOKENS 함수로 미리 추정할 수 있다(AI.AGG 레퍼런스).
알려진 제한도 있다. instruction에 NULL을 넘기면 잘못된 쿼리 오류 대신 내부 오류가 날 수 있고, JOIN이나 ORDER BY ... LIMIT 같은 복잡한 쿼리에서는 모델이 실제로 처리하는 행 수가 예상과 다를 수 있다. 입력 행 수를 엄격히 통제해야 하면 대상 행을 먼저 별도 테이블에 저장한 뒤 그 테이블에 AI.AGG를 실행한다.
AI.AGG 결과가 맞는지 확인하는 법
처음 실행은 전체 데이터가 아니라 일부 행으로 한다. 공식 예제도 LIMIT 5000처럼 행 수를 제한한 서브쿼리에 AI.AGG를 적용한다(AI.AGG 레퍼런스).
- 집계할 열이 STRING인지 확인하고, 대상 행을 WHERE와 LIMIT으로 줄인 임시 테이블에 저장한다.
- 그 테이블에 AI.AGG를 실행하고, 결과가 그룹당 한 줄로 나왔는지 본다.
- 요약에 나온 주제나 감성 몇 가지를 원본 행에서 검색해 실제로 있는지 대조한다.
- 요약이 맞으면 max_error_ratio를 정해 전체 데이터로 넓힌다. 쿼리가 오류로 끝나면 메시지에 가장 빈번한 오류 유형이 담긴다.
자주 묻는 질문
AI.AGG와 AI.GENERATE는 무엇이 다른가요?
공식 문서는 집계 작업에 AI.GENERATE나 AI.GENERATE_TEXT 대신 AI.AGG를 권한다. AI.AGG는 자동 다단계 집계로 컨텍스트 창을 넘는 데이터도 처리하고 입력 그룹당 결과 하나를 돌려준다.
AI.AGG에서 어떤 Gemini 모델을 쓸 수 있나요?
endpoint 인자에 thinking budget이 필요 없는 Gemini 모델을 지정할 수 있고, 지정하지 않으면 빅쿼리가 모델을 고른다. 지원 모델 목록은 레퍼런스 문서의 endpoint 항목에서 확인한다.
이미지나 PDF도 집계할 수 있나요?
된다. Cloud Storage 파일을 참조하는 ObjectRef 값을 입력으로 넣으면 이미지, 동영상, 오디오, PDF를 집계한다. 한도는 입력 종류별로 다르다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.