빅쿼리 연합 쿼리는 빅쿼리에서 다른 데이터베이스에 SQL을 보내 그 결과를 바로 읽는 기능이다(공식 개요). 구글은 2026년 11월 13일 빅쿼리 릴리스 노트에서 MySQL, Oracle, PostgreSQL 연결과 각각의 연합 쿼리를 프리뷰(정식 출시 전 시험 공개)로 공개했다. 자기 서버나 온프레미스(회사 안 서버)에 MySQL·PostgreSQL을 두고 데이터를 빅쿼리로 복사해 왔다면, 복사 없이 조회하는 길이 하나 더 생긴 것이다. 다만 읽기 전용이고 필터가 자동으로 전달되지 않아서, 매일 큰 표를 읽는 용도로 바로 갈아타기에는 맞지 않는다.
빅쿼리가 MySQL, Oracle, PostgreSQL에 연결을 만들고 EXTERNAL_QUERY 함수로 그 데이터베이스에서 SQL을 실행해 결과를 받아 오는 연합 쿼리를 프리뷰로 열었다.
지원 버전은 MySQL 8.4 LTS·8.0, PostgreSQL 16·15, Oracle 23ai·21·19이고, 조회만 되며 BigQuery 쪽 연합 쿼리 자체에는 추가 요금이 없다고 PostgreSQL 문서가 밝힌다.
빅쿼리 데이터 담당자는 연결을 만드는 권한부터 확인하고, 일반 마케터는 이 기능이 켜졌다는 사실만 알아 두면 된다.
MySQL·Oracle·PostgreSQL 연합 쿼리로 바뀌는 것
연합 쿼리(federated query)는 데이터를 빅쿼리 안으로 옮기지 않고, 원래 있는 곳에서 조회하는 방식이다. 빅쿼리 문서에 따르면 EXTERNAL_QUERY 함수에 연결 이름과 SQL을 넣으면 그 SQL이 외부 데이터베이스에서 실행되고 결과가 빅쿼리로 스트리밍된다. 그 결과를 빅쿼리 표와 조인(JOIN)해 쓸 수 있다.
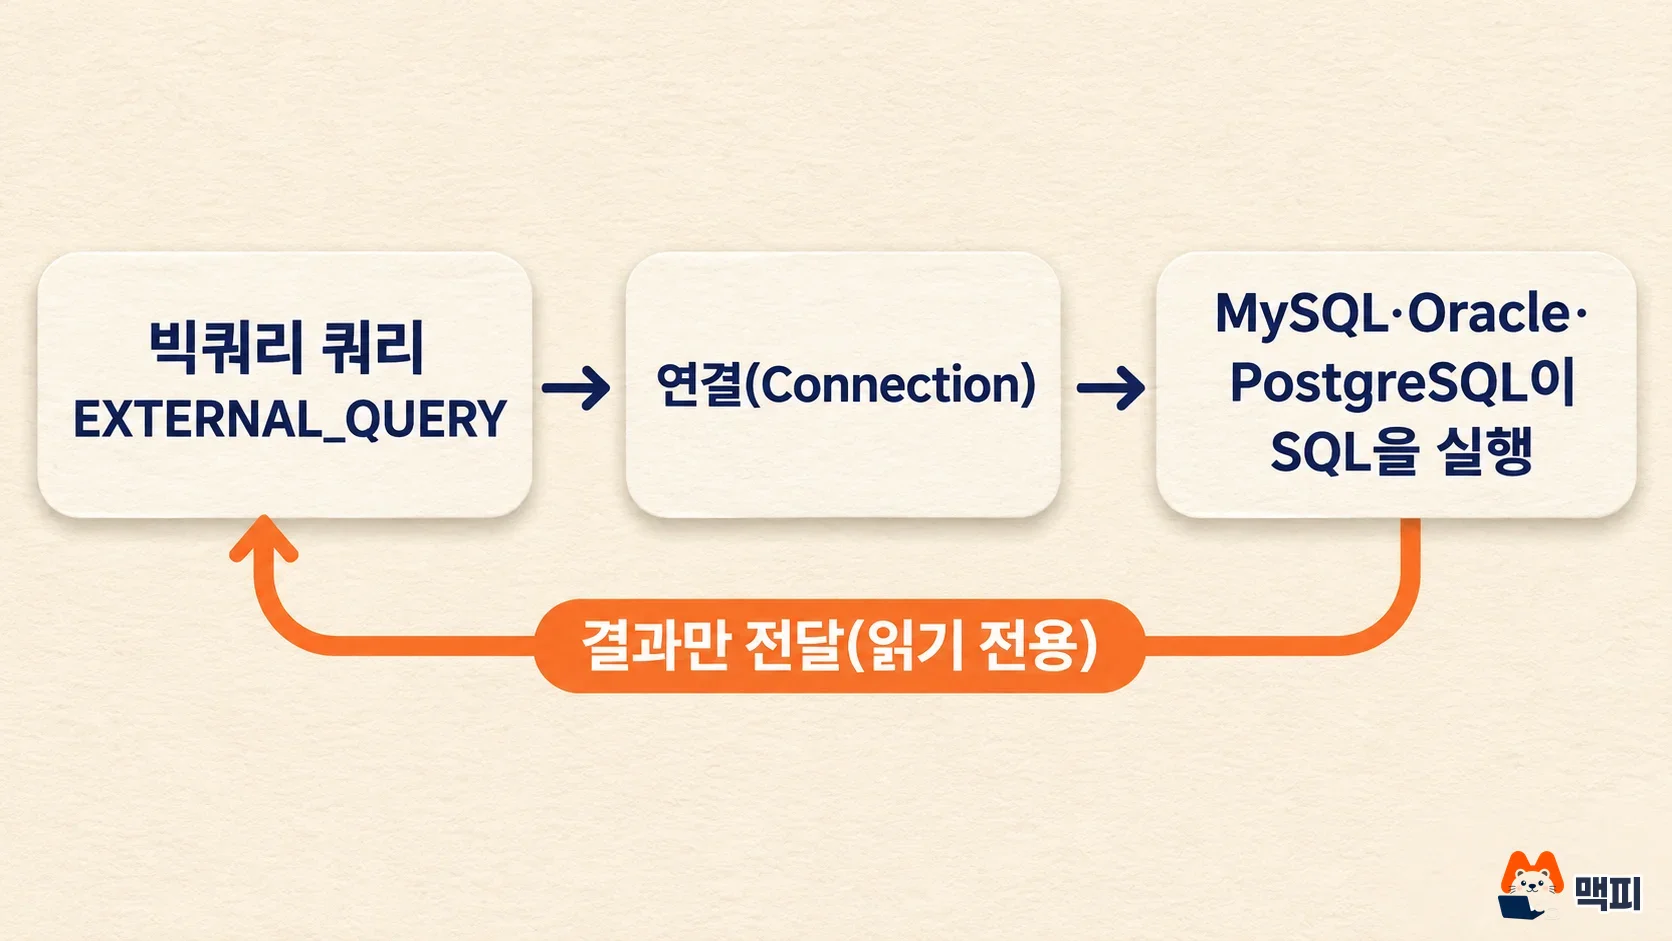
이번 릴리스 노트의 문장은 한 줄이다. 세 데이터베이스에 대한 빅쿼리 연결이 사용 가능해졌고, 이 연결로 MySQL·Oracle·PostgreSQL 연합 쿼리를 실행할 수 있으며 세 기능 모두 프리뷰라는 내용이다.
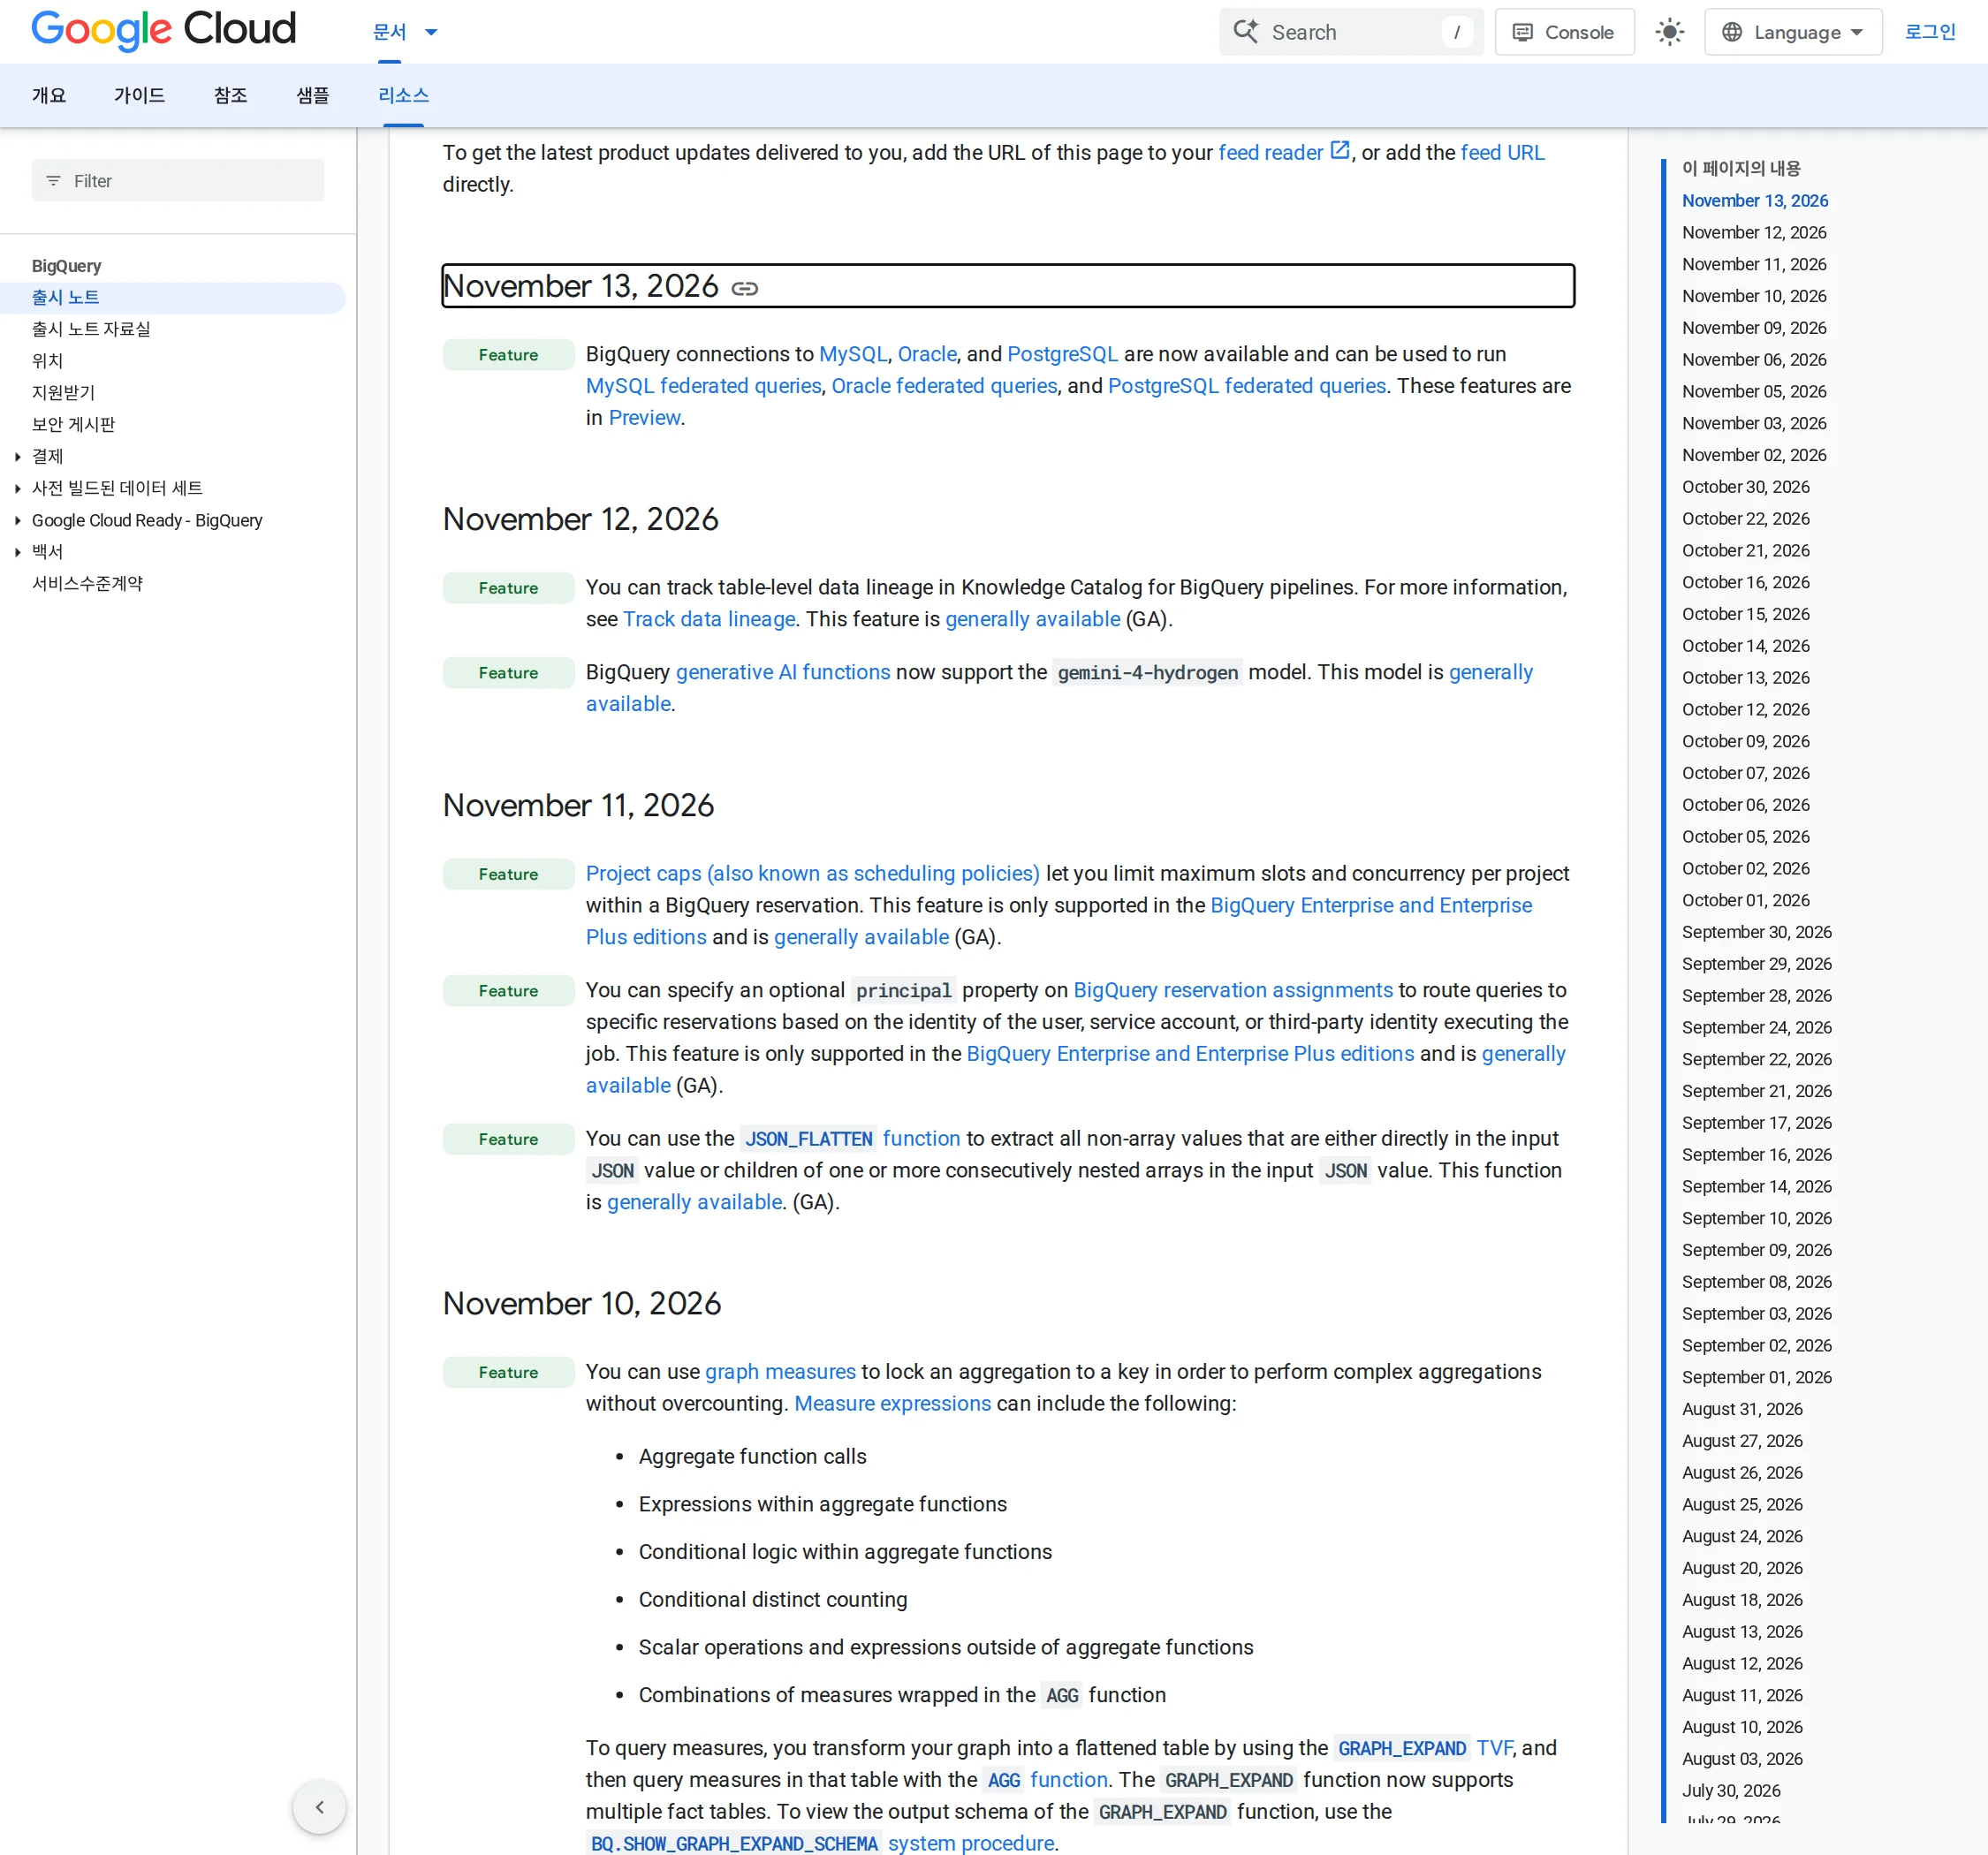
화면에는 11월 13일 항목이 "BigQuery connections to MySQL, Oracle, and PostgreSQL are now available and can be used to run MySQL federated queries, Oracle federated queries, and PostgreSQL federated queries. These features are in Preview."로 적혀 있다. 바로 아래 11월 12일 항목은 파이프라인 데이터 리니지(데이터가 어디서 왔는지 추적하는 기능) 정식 출시여서 이 소식과는 별개다.
데이터베이스별 지원 버전과 환경
데이터베이스마다 지원 버전과 연결 환경이 다르다. 아래 표는 각 데이터베이스의 연합 쿼리 문서(MySQL, Oracle, PostgreSQL)를 합친 것이다.
| 데이터베이스 | 지원 버전 | 연결할 수 있는 환경 | 인증 방식 |
|---|---|---|---|
| MySQL | 8.4 LTS, 8.0 | 공용 IP 또는 네트워크 연결(Cloud VPN, Cloud Interconnect)로 닿는 클라우드·온프레미스, Compute Engine 등에 직접 설치한 MySQL | 사용자 이름과 비밀번호만 |
| PostgreSQL | 16(권장), 15 | MySQL과 같은 환경 | 사용자 이름과 비밀번호만 |
| Oracle | 23ai, 21, 19 | Oracle Database@Google Cloud, Exadata Database Service, Cloud VPN·Cloud Interconnect·공용 IP로 닿는 온프레미스 | 사용자 이름과 비밀번호만(OCI IAM, Kerberos, RADIUS 미지원) |
구글 클라우드의 관리형 서비스는 대상이 아니다. 문서는 Cloud SQL for MySQL·PostgreSQL이나 AlloyDB는 각자의 연합 쿼리 커넥터(Cloud SQL 연합 쿼리, AlloyDB 연합 쿼리)를 쓰라고 안내한다. 둘의 큰 차이는 SQL 푸시다운(바깥 쿼리의 필터를 안쪽 데이터베이스로 내려보내는 기능)이다. MySQL 문서는 "No additional SQL pushdowns are supported for MySQL"이라고 적었고, Cloud SQL 커넥터는 푸시다운을 지원한다.
| 대상 데이터베이스 | 쓰는 커넥터 |
|---|---|
| 자체 서버, 온프레미스, 타사 클라우드의 MySQL·PostgreSQL | 이번에 나온 MySQL·PostgreSQL 연결 |
| Cloud SQL for MySQL·PostgreSQL | Cloud SQL 연합 쿼리 |
| AlloyDB for PostgreSQL | AlloyDB 연합 쿼리 |
PostgreSQL 연결 만드는 순서와 성공 확인
세 데이터베이스의 연결 만들기 문서(MySQL, Oracle, PostgreSQL)는 같은 틀이다. PostgreSQL 문서의 순서를 옮긴다. 화면 문구는 문서의 영어 표기 그대로 적는다.
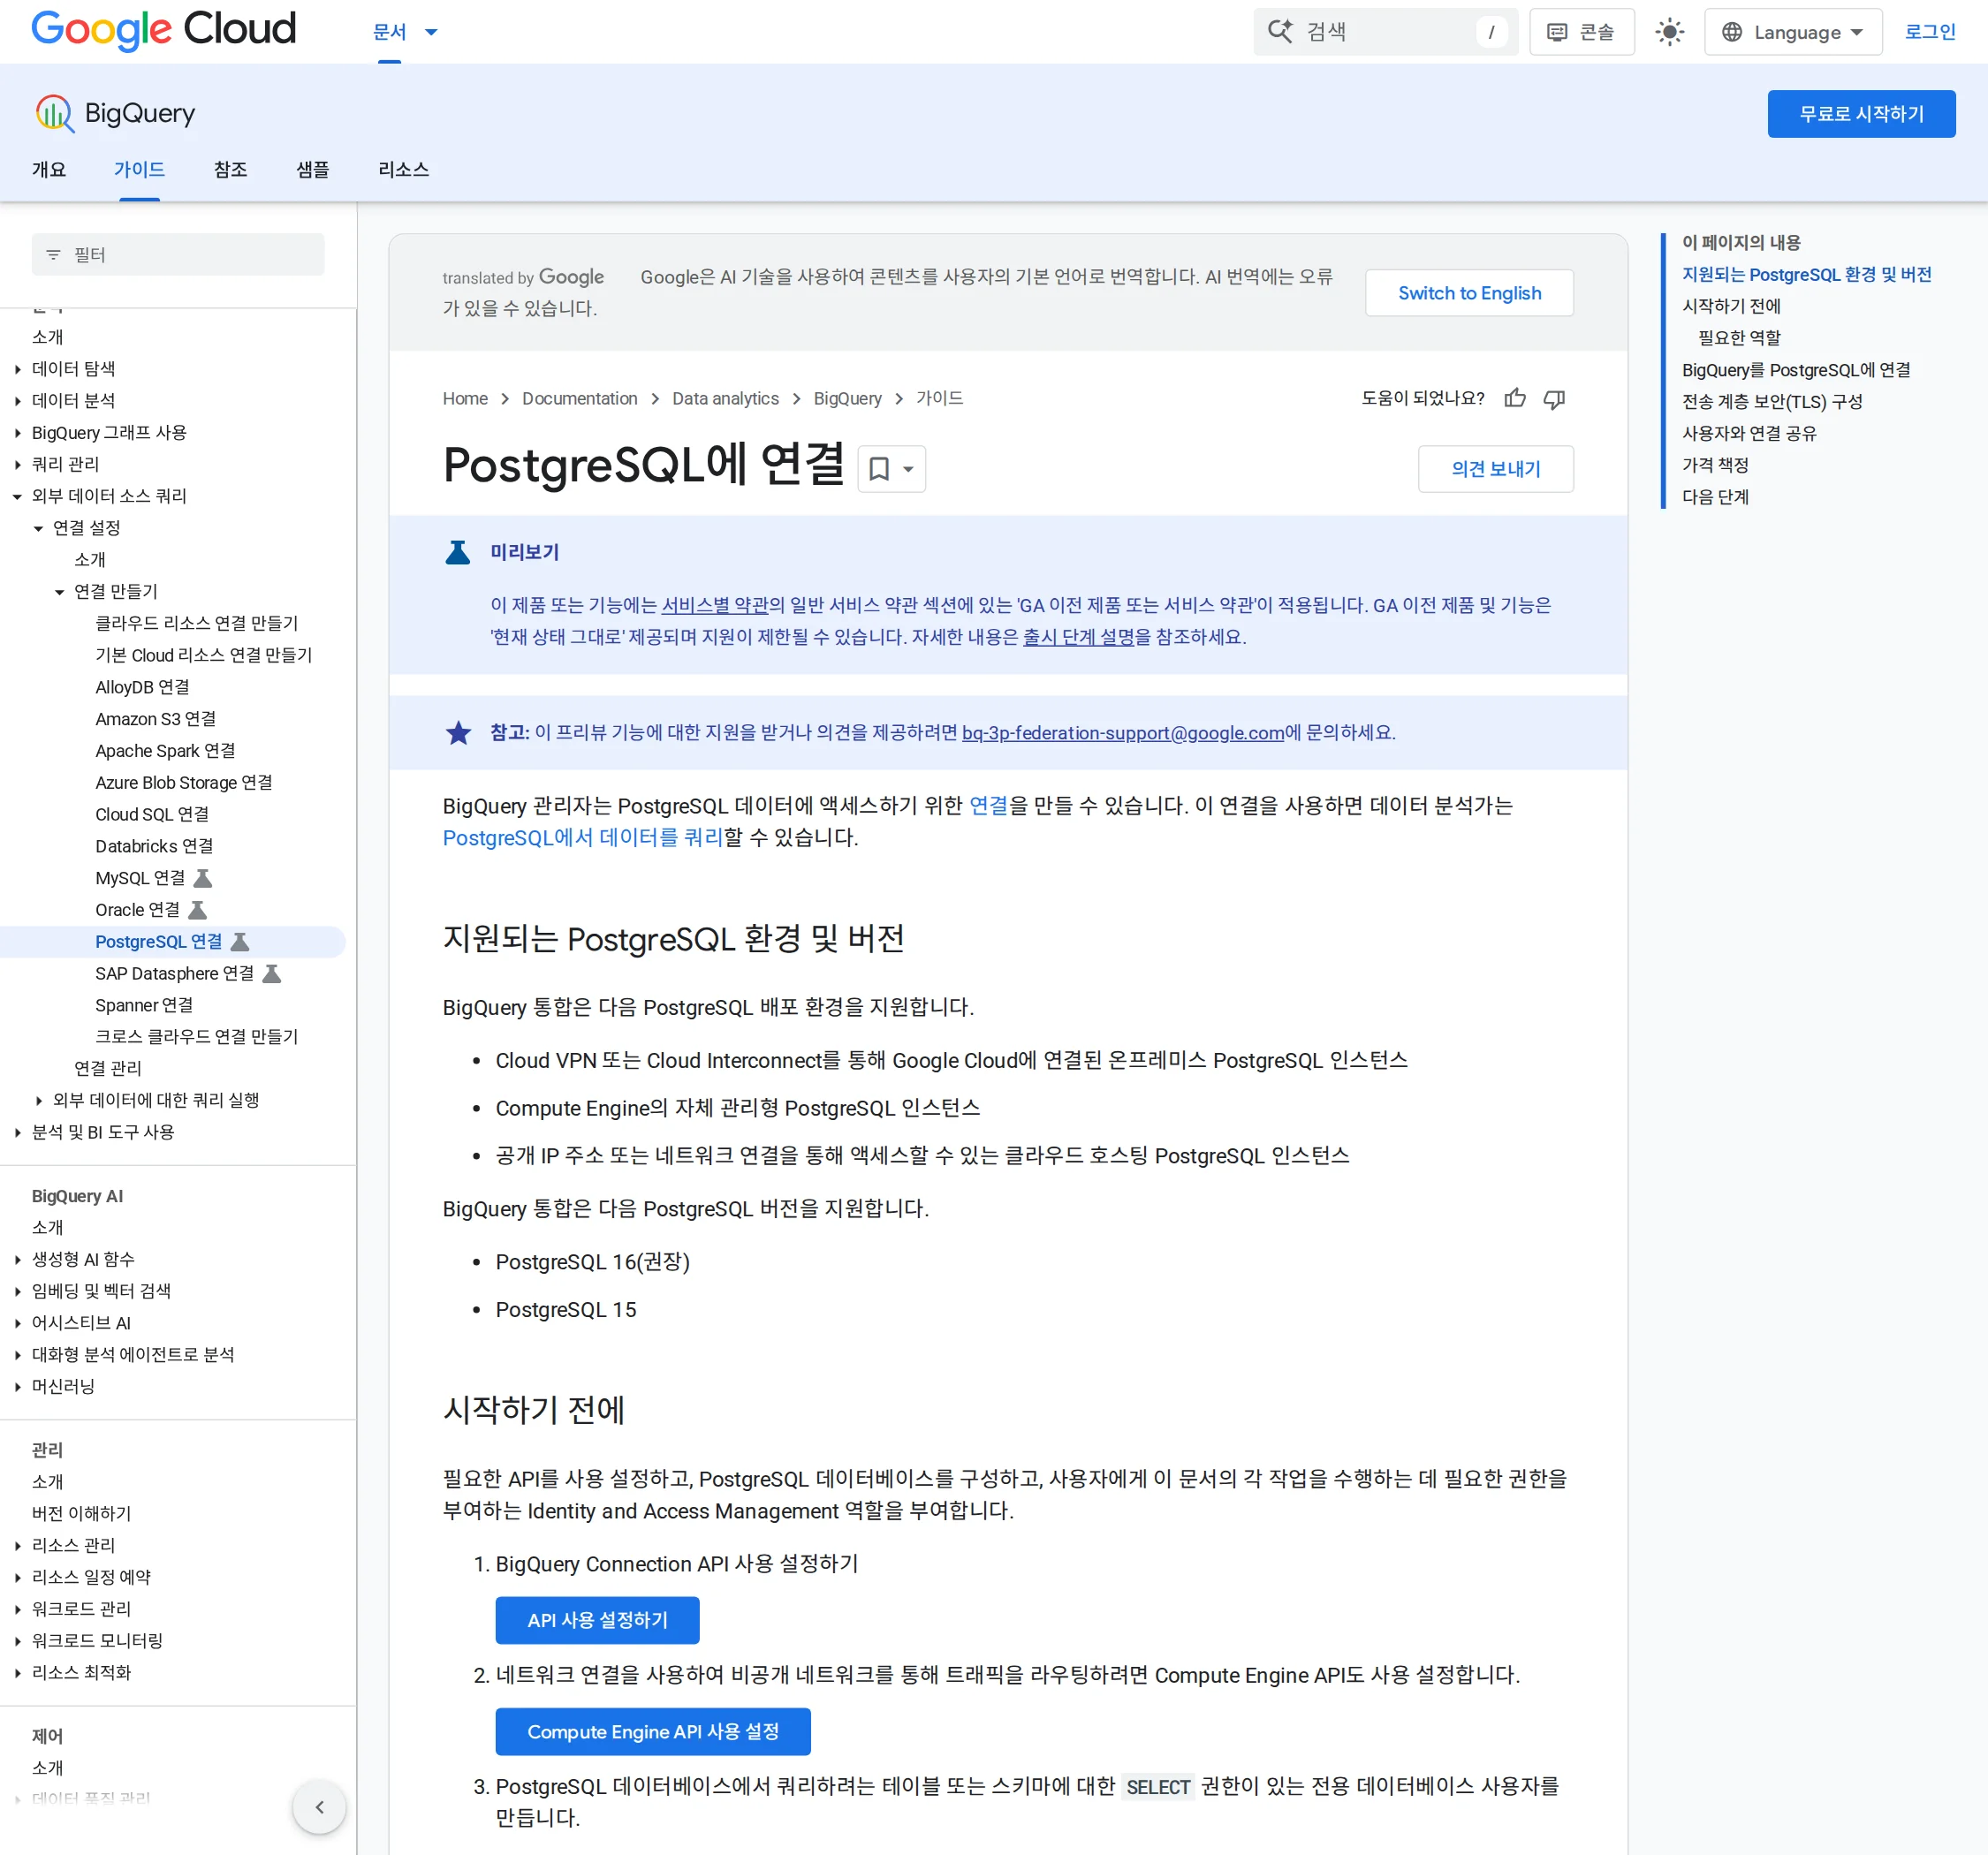
- BigQuery Connection API를 켠다. 네트워크 연결(private network attachment)을 쓸 때는 Compute Engine API도 켠다.
- 외부 데이터베이스에 전용 사용자를 만들고, 조회할 스키마에
USAGE와SELECT만 준다. 문서의 예는CREATE USER,GRANT USAGE ON SCHEMA,GRANT SELECT ON ALL TABLES IN SCHEMA세 줄이다. - 연결을 만드는 사람은 프로젝트에서 BigQuery Connection Admin(
roles/bigquery.connectionAdmin) 역할이 필요하다. - 콘솔에서 BigQuery를 열고 탐색기(Explorer)의 Add data를 누른다. Data Source Type을 Databases로 고르거나 검색창에
postgresql을 넣고, Access external data in place 쪽의 BigQuery Federation(설명 "Federated queries to PostgreSQL") 카드를 고른다. Cloud SQL이나 AlloyDB 카드가 아니다. - Connection ID, 위치 유형(Region), Host:port(예:
10.10.2.2:5432), Username, Password, Database, TLS mode를 넣고 Create connection을 누른다.
공용 인터넷으로 연결하면 데이터베이스 방화벽에 구글 IP 주소 범위를 모두 열어야 하고 TLS 모드는 ENCRYPT_VERIFY_CA_AND_HOST가 필요하다. 사설 연결은 BigQuery 연결과 같은 리전에 네트워크 연결을 만들어야 하고, DNS 피어링은 지원하지 않아 IP 주소나 VPC 안에서 풀리는 호스트 이름을 써야 한다.
연결을 만들었으면 다른 사람이 쓰게 공유한다. 콘솔에서 Explorer의 프로젝트, Connections, 연결 선택, Details의 Share로 가서 BigQuery Connection User(roles/bigquery.connectionUser) 역할을 준다. 문서에 따르면 bq 명령줄로는 공유할 수 없다.
성공 확인은 쿼리 한 줄이면 된다. 문서의 예를 줄이면 아래와 같고, 연결 이름은 projects/내프로젝트/locations/리전/connections/연결ID 형식이다.
SELECT *
FROM EXTERNAL_QUERY(
  'projects/PROJECT_ID/locations/LOCATION/connections/CONNECTION_ID',
  '''SELECT table_schema, table_name, table_type
     FROM information_schema.tables
     WHERE table_schema = 'SCHEMA_NAME' ''');
테이블 목록이 나오면 연결, 권한, 네트워크가 모두 맞은 것이다. 오류가 나면 먼저 연결과 쿼리를 같은 리전에서 실행했는지 본다. 문서는 이 연결을 쓰는 쿼리가 연결과 같은 리전에서 실행돼야 한다고 밝힌다.
고객 표와 주문 DB 합치기: 쿼리 예시
마케터가 가장 자주 부딪히는 경우는 주문 시스템 데이터베이스와 빅쿼리의 광고·GA4 데이터를 합치는 일이다. PostgreSQL 문서의 예가 이 모양이다. 빅쿼리의 고객 표에 PostgreSQL 주문 표의 고객별 첫 주문일을 붙인다.
SELECT c.customer_id, c.name, fo.first_order_date
FROM mydataset.customers AS c
LEFT OUTER JOIN EXTERNAL_QUERY(
  'projects/my-project/locations/us-central1/connections/postgres_prod_conn',
  '''SELECT customer_id, MIN(order_date) AS first_order_date
     FROM orders
     GROUP BY customer_id''') AS fo
ON fo.customer_id = c.customer_id;집계(GROUP BY)를 바깥 빅쿼리가 아니라 안쪽 PostgreSQL SQL에 넣은 점을 눈여겨본다. 푸시다운이 없어서 바깥에 쓴 필터와 집계는 외부 데이터베이스로 전달되지 않는다. 안쪽에서 줄이지 않으면 큰 표가 통째로 네트워크를 타고 온다. 문서도 필요한 행과 열을 EXTERNAL_QUERY 안에서 미리 제외하라고 권한다.
프리뷰 제한과 타입 변환에서 걸리는 것
세 문서에 공통으로 적힌 제한은 다음과 같다.
| 제한 | 의미 | 대응 |
|---|---|---|
| 읽기 전용 | DDL·DML 불가 | 쓰기는 원래 데이터베이스에서 한다 |
| 외부 테이블 없음 | 외부 DB 표에 대응하는 빅쿼리 외부 테이블이나 영구 데이터세트를 못 만든다 | 매번 EXTERNAL_QUERY를 쓰거나 결과를 빅쿼리 표로 저장한다 |
| 첫 쿼리 지연 | 쉬던 연결의 첫 쿼리는 1분 이상 걸릴 수 있다 | 예약 쿼리 타임아웃을 넉넉히 둔다 |
| 별칭 필수 | 함수·표현식 열에 이름이 없으면 빅쿼리 스키마가 깨진다 | COUNT(*) AS total_count처럼 적는다 |
| 푸시다운 없음 | 바깥 필터·집계가 안쪽으로 안 내려간다 | 안쪽 SQL에서 줄인다 |
| VPC Service Controls | 네트워크 연결을 쓰면 실패할 수 있다 | 인그레스·이그레스 규칙을 설정한다 |
타입 변환도 확인한다. 새 표를 만드는 CREATE TABLE ... AS SELECT에서 MySQL의 TINYINT·SMALLINT·FLOAT, PostgreSQL의 smallint·real 열을 그대로 고르면 Unsupported type 오류가 난다. 이때는 CAST(열 AS INT64)나 FLOAT64로 바꿔 고른다. 기존 표에 넣는 INSERT INTO ... SELECT는 자동 변환된다. 소수점 큰 수(DECIMAL, numeric)는 BIGNUMERIC(76, 38)로 가서 정수부가 38자리를 넘으면 실패하고, 이때는 문자열로 캐스팅해 읽는다.
Oracle은 정밀도를 지정하지 않은 NUMBER가 STRING으로 온다. 금액 계산에 쓰려면 빅쿼리 쪽에서 숫자로 바꿔야 한다. 공간 타입(SDO_GEOMETRY), 컬렉션, BFILE, 바이너리 JSON은 지원되지 않는다. 세 데이터베이스 모두 1582년 10월 15일 이전 날짜는 달력 전환 때문에 10일 어긋날 수 있다.
비용과 지금 할 일
PostgreSQL 연합 쿼리 문서는 비용을 세 갈래로 나눈다. 외부 데이터베이스에서 쿼리를 실행하는 컴퓨팅 비용과 결과를 내보내는 데이터 전송 비용은 그 데이터베이스를 호스팅하는 곳이 청구한다. 빅쿼리 쪽은 쿼리 실행 비용만 들고 연합 쿼리 자체의 추가 요금은 없다고 적혀 있다. Cloud VPN, Cloud NAT 같은 구글 클라우드 네트워크 구성 요소를 쓰면 그 요금이 따로 붙는다. 연결 만들기 문서는 표준 연합 쿼리 요금이 적용된다고 안내하므로 청구 전에 이 페이지도 본다.
| 상황 | 할 일 |
|---|---|
| 자체 MySQL·PostgreSQL 데이터를 매일 빅쿼리로 복사한다 | 작은 표 하나로 연결과 EXTERNAL_QUERY를 시험하고, 복사 방식을 바꿀지는 정식 출시 뒤에 정한다 |
| Cloud SQL이나 AlloyDB를 쓴다 | 이번 기능 대상이 아니다. 기존 연합 쿼리 커넥터를 그대로 쓴다 |
| Oracle 데이터를 분석에 붙이고 싶다 | 지원 버전(19, 21, 23ai)과 접속 방식(사용자 이름·비밀번호)부터 맞는지 본다 |
| 빅쿼리를 보고서로만 쓴다 | 할 일이 없다. 데이터 담당자가 연결을 만들면 쿼리에 EXTERNAL_QUERY가 보이는 정도다 |
구글 문서에 따르면 프리뷰는 정식 출시 전 단계라서 서비스 약관의 프리뷰 조건이 적용되고 지원이 제한될 수 있다. 문서는 문의처로 bq-3p-federation-support@google.com을 안내한다. 운영 중인 매출 보고서의 유일한 데이터 경로로 삼기보다, 복사 파이프라인과 결과를 나란히 두고 비교해 보는 용도가 안전하다. 비교 방법은 간단하다. 같은 기간의 건수와 합계를 EXTERNAL_QUERY 결과와 기존 복사 표에서 각각 구해 같은지 본다.
빅쿼리 쿼리 작성을 편하게 하는 기능은 빅쿼리 컬럼 별칭 재사용·리전 간 테이블 복사 글에서 다뤘다. 연합 쿼리 안쪽의 SQL에는 빅쿼리 문법이 아니라 외부 데이터베이스 문법을 써야 한다는 점만 다르다. 바깥 쿼리를 쓸 때 편집기의 Gemini 도움을 받고 싶다면 빅쿼리 SQL 편집기 Gemini 버튼 사용법을 본다.
자주 묻는 질문
빅쿼리에서 PostgreSQL 데이터를 수정할 수도 있나요?
수정은 안 된다. 문서에 따르면 EXTERNAL_QUERY는 읽기 전용이고 DDL과 DML은 지원되지 않는다.
MySQL 데이터에 대해 빅쿼리 외부 테이블을 만들 수 있나요?
만들 수 없다. 연합 쿼리는 EXTERNAL_QUERY 함수로만 쓸 수 있고, MySQL 표에 바로 대응하는 외부 테이블이나 영구 데이터세트는 지원하지 않는다.
연결 쿼리가 처음에 오래 걸리는 이유가 뭔가요?
쓰지 않은 연결이 휴면 상태가 될 수 있어서다. 문서는 오랜만의 첫 쿼리가 1분 이상 걸릴 수 있다고 밝힌다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.