제미나이 API 툴 검색 프리뷰, 도구가 많은 앱만 토큰이 줄어든다
제미나이 API의 툴 검색(tool retrieval)은 도구 정의를 매 요청에 전부 싣지 않고, 모델이 필요할 때 검색해 불러오게 하는 기능이다. 구글은 2026년 11월 19일 변경 기록에서 Interactions API에 프리뷰로 추가됐다고 밝혔다. 도구가 수십 개 이상이고 요청마다 몇 개만 쓰는 앱은 입력 토큰이 크게 줄 수 있다. 도구가 10개쯤이고 대화가 긴 앱은 오히려 늘 수 있어서, 켜기 전에 계산부터 해 봐야 한다.
2026년 11월 19일, 제미나이 Interactions API에 도구 정의를 필요할 때만 불러오는 툴 검색이 프리뷰로 들어왔다.
추가 요금은 없고 모델의 기본 입력·출력 요금을 따르며, 구글 문서의 예시에서 도구 200개 앱은 입력 토큰이 약 164,000에서 23,650으로 줄지만 도구 10개에 긴 대화 앱은 68,000에서 92,830으로 는다.
generateContent에서는 쓸 수 없고 v1beta Interactions API 전용이며, 지원 모델은 문서 기준 gemini-4-hydrogen·gemini-4-argon·gemini-3.8-flash·gemini-3.6-flash다.
정적 로딩, 서버 검색, 클라이언트 검색 중 무엇을 고를까
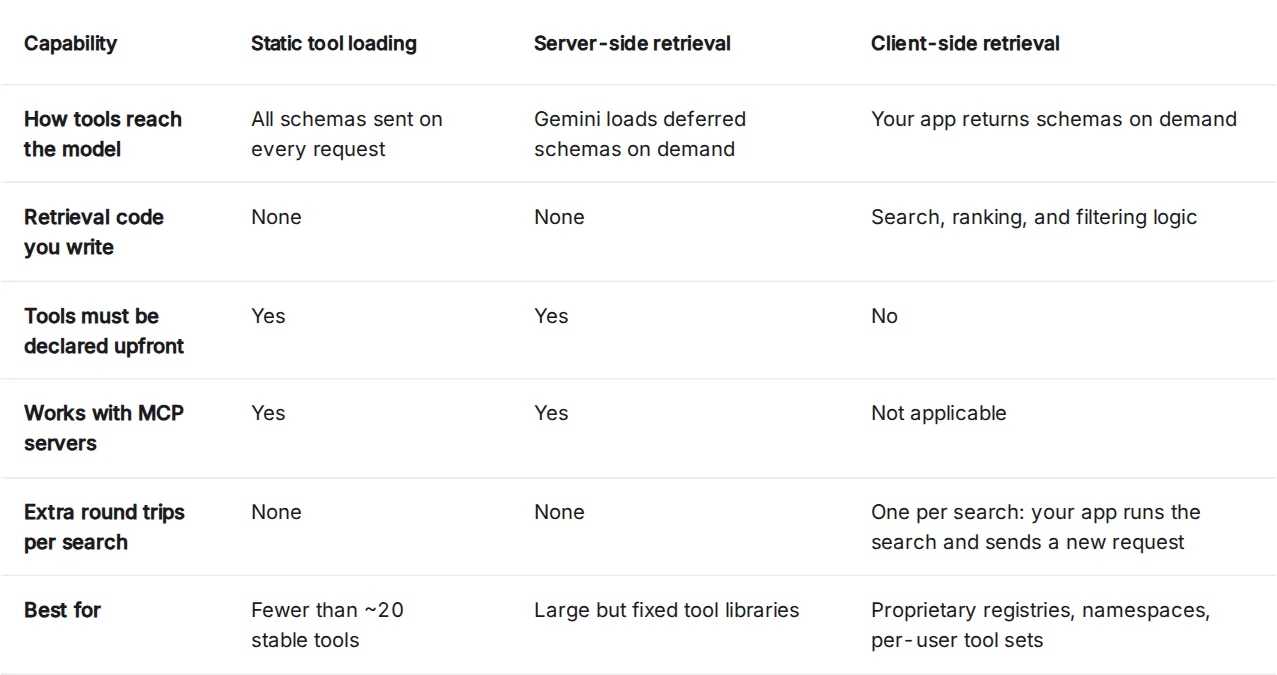
구글 툴 검색 문서는 도구를 모델에 전하는 방식을 세 가지로 나눈다. 지금까지는 모든 도구 정의를 매 요청에 보내는 정적 로딩이 기본이었다.
| 구분 | 정적 로딩 | 서버 검색 | 클라이언트 검색 |
|---|---|---|---|
| 도구가 모델에 닿는 방식 | 매 요청에 전부 전송 | 제미나이가 보류된 도구를 필요할 때 로드 | 우리 앱이 필요할 때 도구를 돌려줌 |
| 직접 짜는 검색 코드 | 없음 | 없음 | 검색·순위·필터 로직 |
| 검색 한 번당 추가 왕복 | 없음 | 없음(API 호출 한 번 안에서 처리) | 한 번 |
| 잘 맞는 경우 | 안정적인 도구 약 20개 미만 | 크지만 고정된 도구 목록 | 자체 도구 레지스트리, 사용자별 도구 세트 |
그림 1은 문서의 비교표 원본이다. 서버 검색이 기본값이라 설정이 가장 간단하고, 클라이언트 검색은 사용자가 새 연동을 붙인 뒤 도구를 대화 도중에 추가하는 식의 구성에 쓴다. 문서에서 정적 로딩은 도구가 약 20개 미만으로 안정적일 때 맞는다고 하므로, 그 아래 규모라면 지금 방식을 유지해도 된다. 출처: 구글 Gemini API 문서 캡처(2026년 11월 20일).
제미나이 툴 검색 설정 순서와 확인 방법
서버 검색은 tools 배열에 {"type": "tool_search"}를 하나 넣고, 보류할 함수에 defer_loading: true를 붙이면 된다. 문서는 mcp_server 항목에 붙이면 그 서버의 도구 전체가 보류된다고 설명한다. 모델은 보류된 도구의 이름과 설명만 보고, 필요하면 검색 단계를 내보내며 API가 전체 스키마를 돌려준다.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
tools = [
    {"type": "tool_search"},
    {"type": "function", "name": "convert_currency",
     "description": "Convert an amount between currencies.",
     "defer_loading": True,
     "parameters": {"type": "object",
       "properties": {"amount": {"type": "number"}, "to": {"type": "string"}},
       "required": ["amount", "to"]}},
]
interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Convert 100 USD to EUR.",
    tools=tools,
)
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
위 코드는 구글 문서의 예시를 줄인 것이다. 제대로 동작하면 steps에 검색 단계와 검색 결과 단계가 먼저 보이고, 그 뒤 function_call이 나온다. 검색 단계는 API 호출 한 번 안에서 처리되므로 우리 코드가 응답할 필요는 없고, function_call만 실행해 function_result로 돌려주면 된다. 문서는 status 값에 기대지 말고 function_call 단계가 있는지로 판단하라고 안내한다.
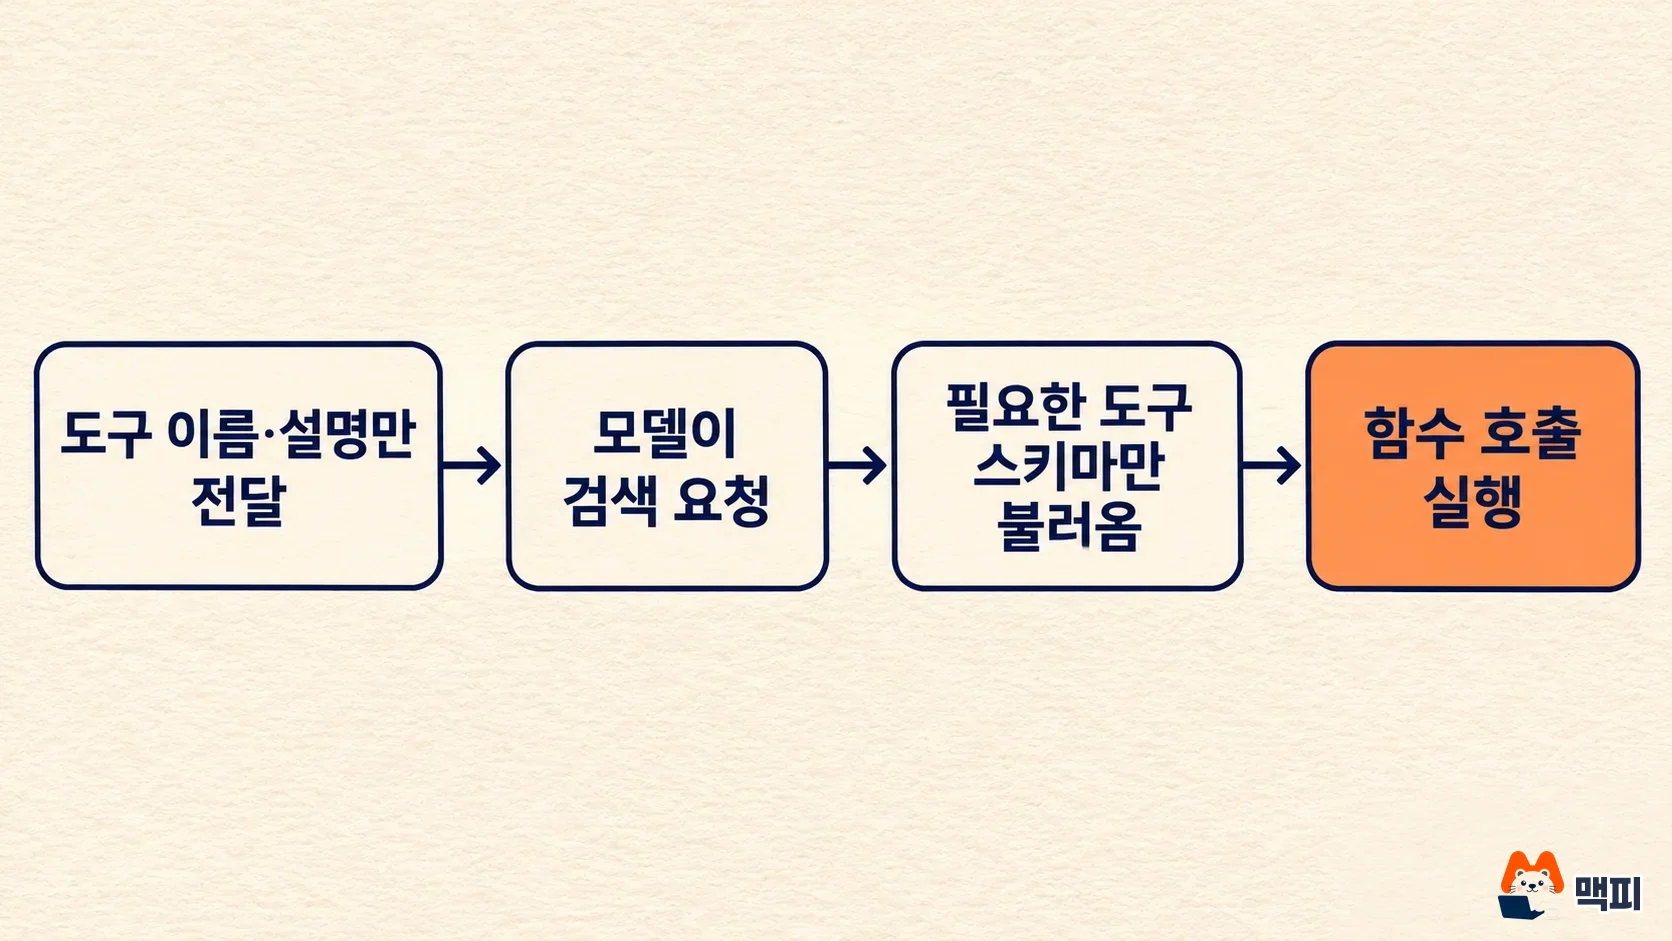
그림 2는 요청이 도는 순서다. 구글 문서는 넓게 켜기 전에 자기 트래픽으로 재 보라고 안내한다. 같은 모델에 정적 로딩 요청과 툴 검색 요청을 따로 보내고 응답의 total_tool_use_tokens와 입력 토큰을 비교하면 이득인지 알 수 있다. 이 비교 방법은 문서 예시를 응용한 맥피의 제안이다.
요청마다 도구 배열을 다시 보내야 하는 이유와 400 오류
도구 선언은 요청 사이에 저장되지 않는다. 툴 검색 문서에 따르면 previous_interaction_id를 써도 tool_search 항목, 보류된 도구, 보류하지 않은 도구를 모두 매번 다시 보내야 한다. 빼먹으면 모델이 이전 도구를 계속 호출하려 할 수 있다. store=false로 상태를 직접 관리하면 검색 호출과 결과 단계를 signature까지 그대로 순서대로 돌려보내야 한다. 저장 기본값이 바뀐 배경은 제미나이 API 요청 저장 기본값 글에서 볼 수 있다.
| 오류 문구 | 고치는 방법 |
|---|---|
| tool_search tool must be specified when using defer_loading. | tool_search 항목을 넣거나 defer_loading을 뺀다 |
| Cannot specify both client-side and server-side tool_search tools. | 한 종류만 선언한다 |
| deferred loading is not supported for this model | 지원 모델로 바꾼다 |
| short_description can only be set if defer_loading is true | defer_loading을 켜거나 short_description을 뺀다 |
| Server side tool call context must be circulated when using deferred loading functions. | 상태 비저장 흐름에서 빠뜨린 검색 단계를 그대로 다시 보낸다 |
| Tool call part is missing thought_signature. | 검색 단계에서 지워진 signature를 복구한다 |
토큰이 줄어드는 앱과 늘어나는 앱
구글은 툴 검색 문서의 청구 항목에서 별도 요금 없이 모델의 기본 입력·캐시·출력 요금을 적용한다고 밝혔다. 다만 보류된 도구마다 이름과 짧은 설명이 한 줄씩 입력에 들어가고, 초기 테스트 기준 도구당 약 26토큰이다. 서버 검색이 일어날 때마다 같은 요청 안에서 전체 대화에 불러온 스키마까지 더한 모델 호출이 한 번 더 돌고, 그 프롬프트 전체가 total_tool_use_tokens로 잡힌다. 불러온 스키마는 대화가 끝날 때까지 남아 이후 호출에서 입력으로 계산되며, 한 번 불러온 도구를 내릴 방법은 없다.
그림 3의 계산을 풀면 이렇다. 도구 200개 예시는 첫 요청이 2,000토큰 대화, 보류 목록 5,200토큰(200개×26), 지시문 150토큰을 합쳐 7,350이고, 검색 호출이 8,150을 더하며, 두 번째 요청이 8,150이라 약 23,650이다. 도구 10개 예시는 대화가 30,000토큰이라 검색 호출이 그 대화를 한 번 더 보내서 정적 로딩의 68,000보다 많은 약 92,830이 된다. 두 예시는 구글이 반올림한 숫자로 만든 설명용 계산이고 측정값이 아니며, 출력 토큰과 캐시는 빠져 있다. 출처: 구글 Gemini API 문서 캡처(2026년 11월 20일).
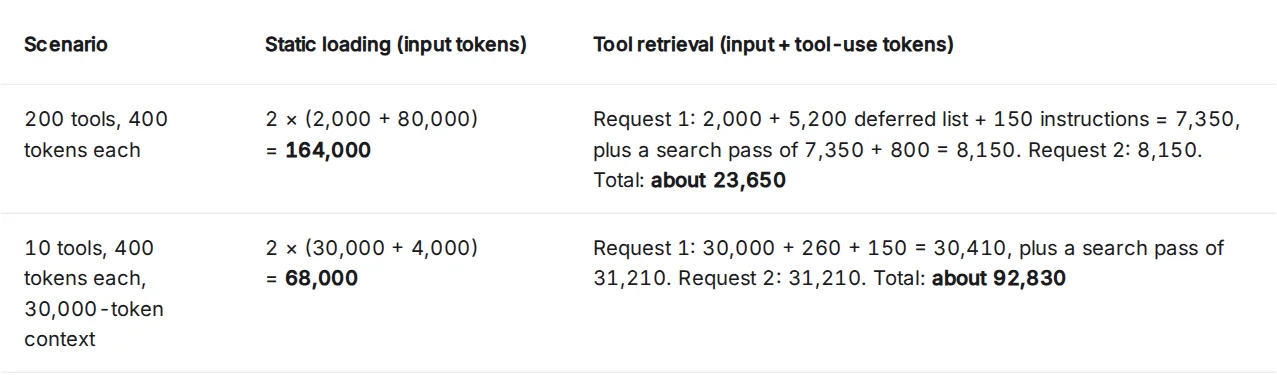
구글 문서의 절감 조건 설명을 정리하면 도구 정의가 큰 비중을 차지하고 요청 대부분이 검색을 안 하거나 한 번만 하는 앱에서 이득이다. 도구가 적거나 대화가 길어 거의 모든 요청이 검색하는 앱은 반대다. 도구를 보류하면 프롬프트가 작아져 모델의 최소 캐시 크기 아래로 떨어질 수도 있다.
세로로 보면 보류 목록과 검색 호출이 입력의 대부분을 차지한다. 불러온 스키마 2개(800토큰)는 작은 몫이라, 도구가 늘어도 목록은 도구당 약 26토큰씩만 늘어난다.
쓰기 전에 알아 둘 제한과 설계 요령
툴 검색 문서의 제한 목록에 따르면 툴 검색은 v1beta의 Interactions API에서만 되고 generateContent에서는 지원하지 않는다. 서버 검색과 클라이언트 검색은 한 요청에서 섞을 수 없고, defer_loading은 서버 검색 전용이다. 맞는 검색 결과가 없으면 구조화된 오류 대신 텍스트로 답이 와서, 검색 결과 단계만으로 검색 실패를 판단하면 안 된다. 문서는 정식 출시 전에 API 형태가 바뀔 수 있다고도 적었다.
모델 지원은 문서의 지원 모델 절과 변경 기록의 표현이 조금 다르다. 변경 기록은 Gemini 3.6 이후 모델이며 Gemini 4 전체가 포함된다고 쓰지만, 툴 검색 문서의 지원 목록은 gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash 네 개다. 지원하지 않는 모델에 defer_loading을 쓰면 400 오류가 나므로 쓰려는 모델이 목록에 있는지 먼저 본다. 하이드로젠의 가격과 무료 티어는 제미나이 4 하이드로젠 정식 출시 글, 3.8 플래시의 교체 일정은 제미나이 API 모델 변경 정리에 있다.
문서의 설계 권고는 자주 쓰는 도구는 보류하지 않고 긴 꼬리만 보류하라는 것이다. 이름으로 직접 부르는 도구는 보류하지 말고, 보류하는 함수에도 전체 파라미터 스키마를 넣어야 한다. 이름과 짧은 설명만 보내면 검색이 빈 스키마를 돌려줘 모델이 호출하지 못한다. 비슷한 함수 이름에는 서비스 이름을 접두어로 붙이고, 언제 검색할지 시스템 지시에 적는다.
클로드·GPT에도 있는 기능이다
앤트로픽은 같은 이름의 툴 검색 도구를 안정(stable) 상태로 제공하고, 정규식과 BM25 두 가지 검색 방식과 요청당 보류 도구 최대 10,000개를 지원한다. OpenAI도 tool_search와 defer_loading을 두며, Responses API에서는 gpt-5.4 이후 모델만 지원한다고 문서에 적었다. 같은 아이디어가 세 회사에 모두 있어도 구현은 다르다.
| 구분 | 제미나이 API | 클로드 API | OpenAI API |
|---|---|---|---|
| 검색 도구 이름 | tool_search | tool_search_tool_regex_20251119, tool_search_tool_bm25_20251119 | tool_search |
| 쓸 수 있는 API | Interactions API 전용(v1beta, 프리뷰) | Messages API 등(안정) | Responses API |
| 지원 모델 | gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash | 클로드 오퍼스 4.5 이후 현행 모델(오퍼스 4.1 이하 제외) | gpt-5.4 이후 모델 |
| 보류 지정 방식 | 함수와 mcp_server 항목에 defer_loading | 도구 정의에 defer_loading, MCP는 mcp_toolset 설정 | 함수와 MCP 서버 도구에 defer_loading, 네임스페이스 지원 |
| 별도 요금 | 없음, 모델 기본 요금 | 별도 서버 도구 요금 없음, 불러온 정의는 입력 토큰 | 문서에 가격 언급 없음 |
도구 검색이 필요한지 판단하는 기준은 비슷하다. 클로드 문서는 도구가 10개 이상이거나 정의가 1만 토큰을 넘으면 쓰라고 권하는데, 제미나이 문서의 약 20개 미만 기준과 숫자가 다르다. 다만 각 문서의 기준이 서로 다른 모델과 계산에서 나온 값이라, 숫자를 그대로 비교하지 말고 자기 앱의 정의 토큰 수를 직접 재서 정하는 편이 낫다.
자주 묻는 질문
툴 검색을 쓰면 요금이 따로 붙나요?
구글 문서는 별도 요금이 없고 모델의 입력·캐시·출력 요금을 그대로 적용한다고 밝혔다. 다만 검색할 때마다 모델 호출이 한 번 더 돌아 입력 토큰은 늘 수 있다.
MCP 서버 도구도 보류할 수 있나요?
원격 mcp_server 항목에 defer_loading을 붙이면 그 서버가 내놓는 도구 전체가 보류된다. 여러 서버에 도구가 많을 때 유용하다고 문서에 적혀 있다.
generateContent로 만든 앱에도 쓸 수 있나요?
쓸 수 없다. 툴 검색은 Interactions API 전용이라, 기존 앱에 쓰려면 먼저 Interactions API로 옮겨야 한다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.