제미나이 TTS 음성 만들기는 글로 목소리를 설명하는 음성 디자인과, 같은 사람의 녹음 두 개로 목소리를 따라 만드는 음성 복제 두 가지다. 구글 Gemini API 음성 생성 문서에 따르면 두 방식 모두 gemini-3.8-flash-tts 모델에서 AI Studio나 API로 쓸 수 있고, 결과로 voice_로 시작하는 음성 ID가 나온다. 이 ID를 한 번 만들어 두면 이후 음성 생성 요청마다 그대로 불러 쓴다(2026년 10월 22일 기준).
제미나이 TTS 음성 만들기: 무엇이 달라졌나
매번 대본을 읽어 줄 성우를 새로 뽑는 것과, 마음에 든 성우를 한 번 계약해 두고 계속 부르는 것은 다르다. 제미나이 TTS의 음성 ID는 두 번째 방식에 가깝다. 목소리를 한 번 만들어 저장하고 ID로 부른다. 다만 ID로 고정되는 것은 목소리의 성격이고, 읽는 속도나 감정까지 매번 똑같이 보장되는 것은 아니다.
구글 문서는 모델을 둘로 나눈다. gemini-3.8-flash-tts는 표현력이 중요하거나 여러 화자가 나오는 긴 낭독에, gemini-3.8-flash-lite-tts는 더 빠르고 싼 대량 처리와 음성 에이전트에 맞춘다. 구글 문서에 따르면 두 모델은 요청 형식이 같아서 모델 이름만 바꿔 갈아 끼울 수 있다. 지원 언어는 Flash가 130개 이상, Flash-Lite가 100개 이상이다. 제미나이 API의 다른 모델 교체 소식은 제미나이 API 모델 변경 정리에서 볼 수 있다.
음성 디자인과 음성 복제, 무엇을 고를까
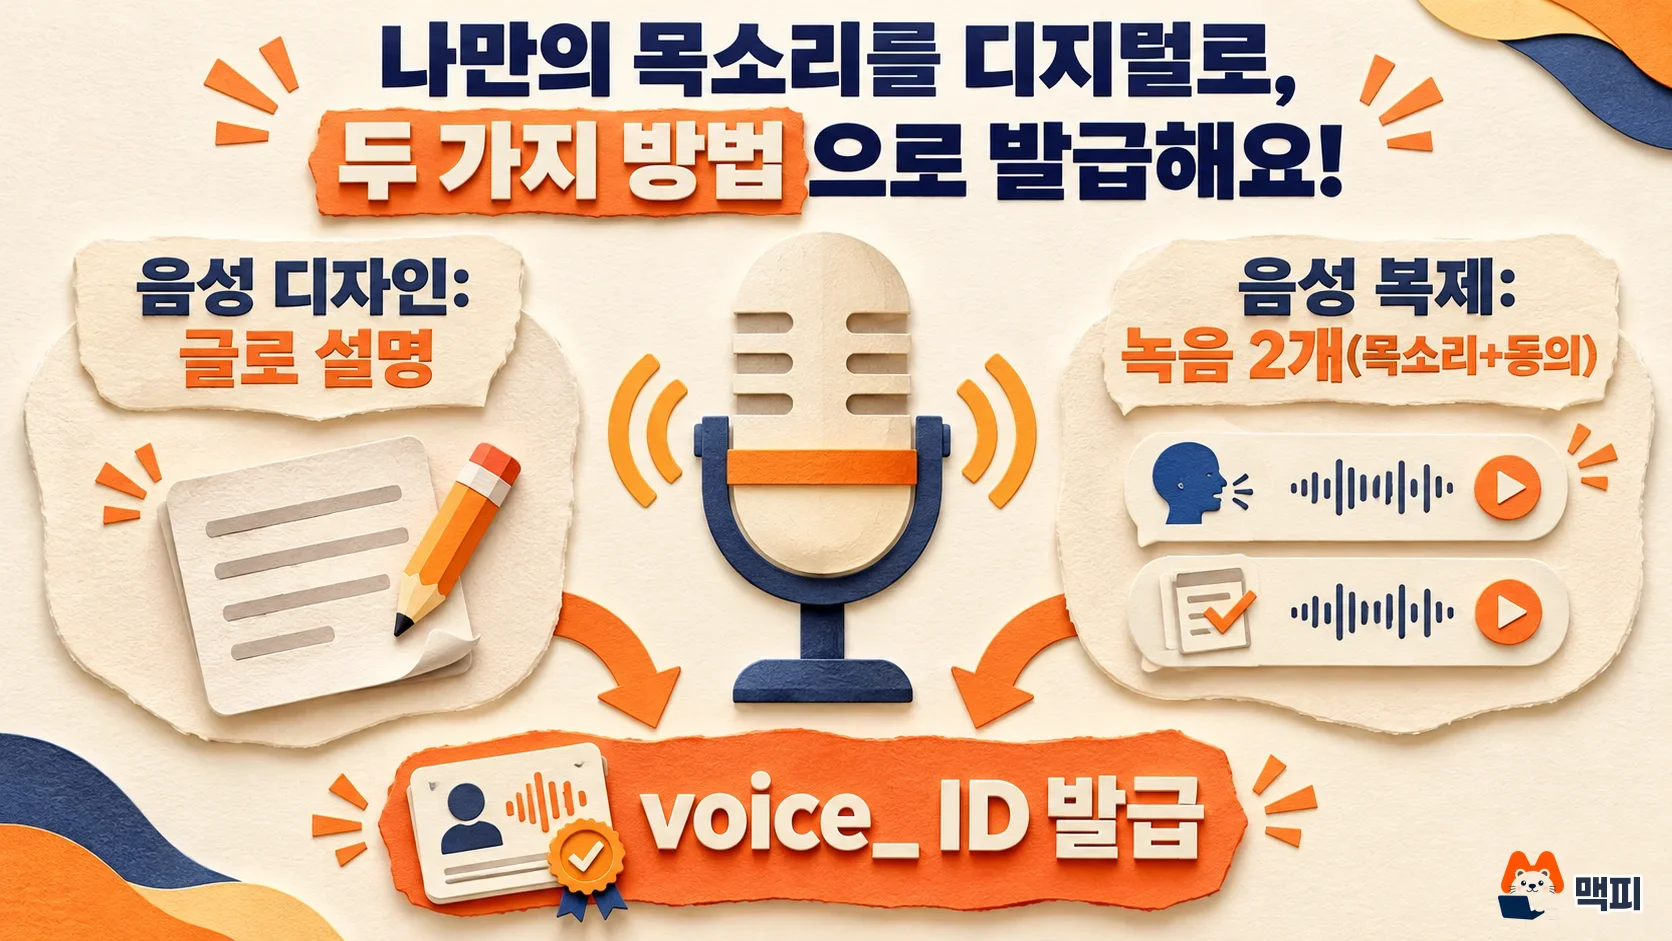
선택 기준은 목소리의 주인이 정해져 있느냐다. 특정 사람의 목소리를 써야 하면 복제를, 그런 제약이 없고 "30대 남성 팟캐스트 진행자" 같은 캐릭터면 디자인을 고른다.
| 구분 | 음성 디자인 | 음성 복제 |
|---|---|---|
| 입력 | 목소리를 설명하는 글 | 참조 녹음과 동의 녹음 각 1개 |
| API 설정값 | type="prompted" | type="replicated" |
| 잘 맞는 경우 | 영상 내레이션, 가상 진행자 캐릭터 | 본인이나 동의한 사람의 목소리를 반복해서 써야 할 때 |
| 필요한 것 | 없음 | 같은 성인 화자의 녹음 2개 |
복제는 사람의 목소리를 쓰는 만큼 조건이 엄격하다. 문서는 참조 녹음과 동의 녹음이 같은 실제 성인 화자에게서 나와야 한다고 요구한다. 따라서 목소리 주인의 동의 녹음 없이는 복제 음성을 만들 수 없다.
제미나이 TTS 음성 디자인 방법
AI Studio에서는 목소리 설명을 입력해 새 음성을 만들 수 있다. 코드로 하려면 구글 문서대로 POST /v1beta/voices에 type="prompted"를 보낸다. 아래는 개발자 필립 슈미트(Phil Schmid)가 제미나이 3.8 TTS 글에 올린 파이썬 예시를 줄인 것이다.
voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "prompted",
        "display_name": "Deadpan host",
        "gender": "male",
        "language_code": "en-US",
        "prompted": {"input": "A dry, deadpan podcast host in his 30s, low pitch, slight German accent."},
    },
)
print(voice.id)  # voice_... 로 시작
설명은 누구인지와 어떻게 들리는지만 담는다. 예시 문장은 역할(팟캐스트 진행자), 나이대(30대), 음높이(낮음), 억양(약한 독일어 억양)을 한 문장에 모았다. 응답에 들어 있는 sample_audio가 미리듣기용 WAV이므로, 긴 대본을 만들기 전에 이것부터 들어 본다.
말하는 태도는 목소리 설명이 아니라 요청 쪽에 둔다. 슈미트의 글은 긴 말투 설명(Audio Profile)을 요청마다 붙이면 목소리가 흔들리는 일이 생기니 성격은 음성에 담고 스타일 문자열은 짧게 쓰라고 권한다. 이것은 개발자 개인의 사용 경험이므로 구글이 정한 규칙은 아니다.
제미나이 TTS 음성 복제 방법: 녹음 2개와 설정
음성 복제 문서의 절차는 아래와 같다.
- 저장 방식을 고른다.
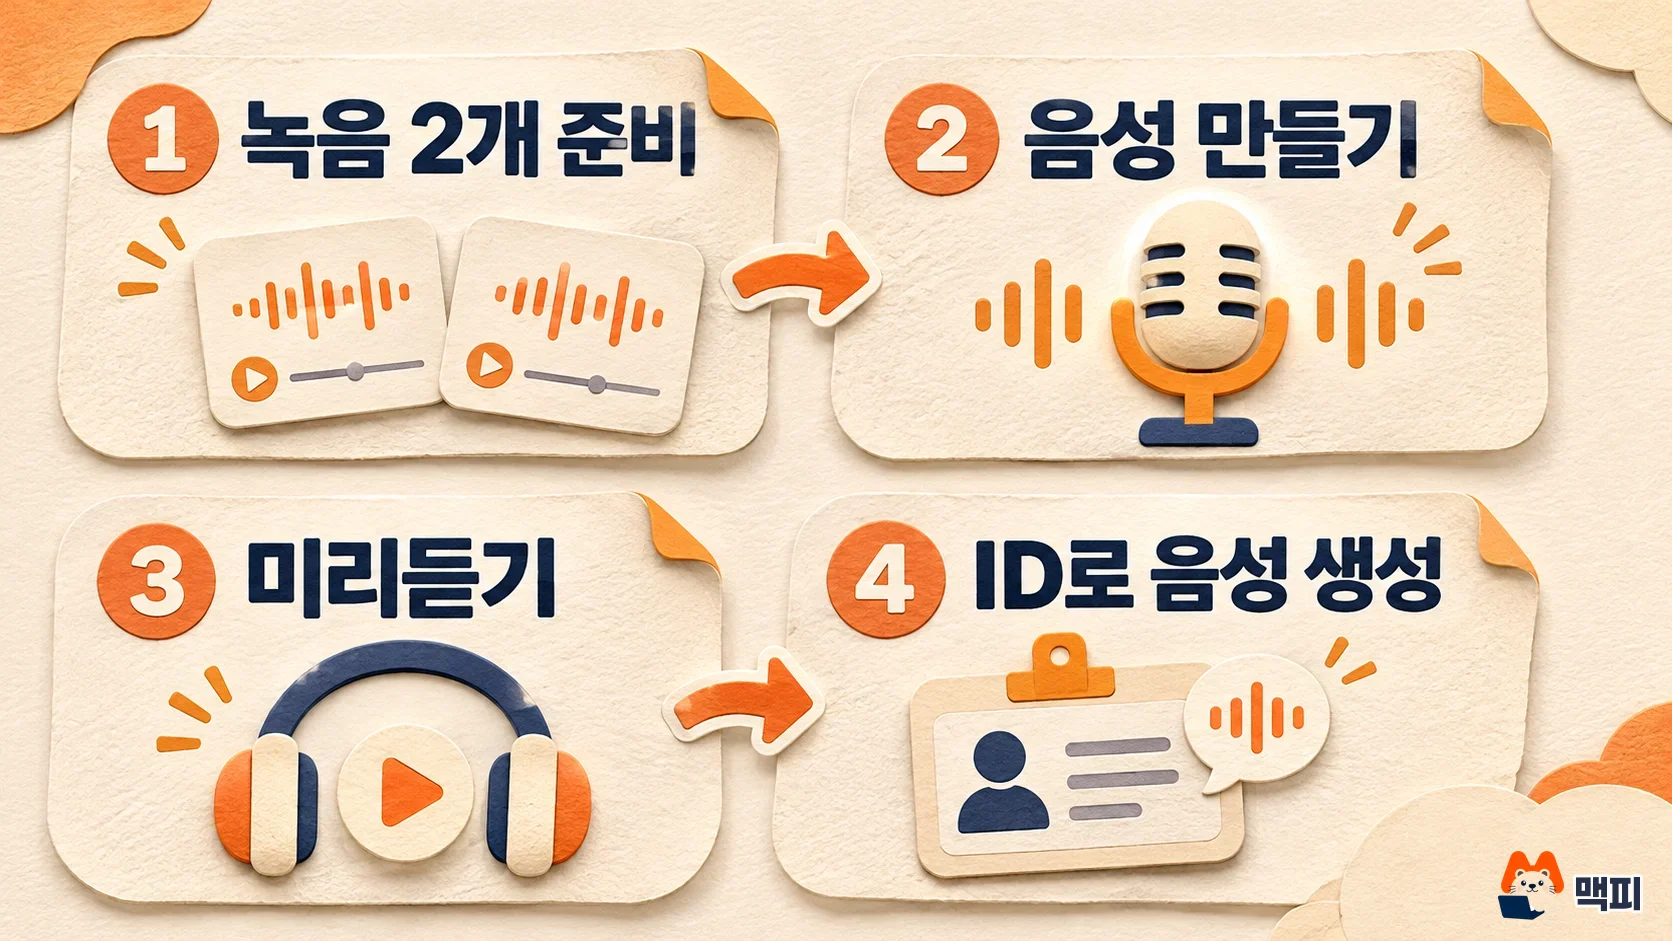
store=True(기본값)는 프로젝트에 저장하고 voice_ ID를 돌려주며,store=False는 직접 보관할 암호화 키(voicekey_)를 돌려준다. - 같은 성인 화자의 녹음 2개를 준비한다. 참조 녹음은 깨끗하고 자연스러운 말 10~30초, 동의 녹음은 같은 사람이 동의 문장을 읽은 것이다. 24kHz 모노 16비트 WAV를 권장한다.
- 조용한 곳에서 같은 마이크와 같은 환경으로 두 개를 모두 녹음한다. 문서는 그래야 화자 검증이 통과한다고 설명한다.
- AI Studio의 음성 복제 화면에서 두 파일을 녹음하거나 올리고 미리 듣는다. API로는
type="replicated"에source_audio와consent_audio를 base64로 담아 보낸다. - 돌려받은 ID를 음성 생성 요청의
generation_config.speech_config에 넣는다.
동의 문장은 언어마다 정해져 있고, 영어는 "I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model."이다. 문서는 동의 문장을 한국어를 포함한 30개 언어로 제공한다고 밝힌다. 동의 녹음은 고른 언어의 문장 그대로 읽어야 한다.
만든 음성으로 낭독 생성하고 확인하기
음성 ID는 요청의 speech_config에 넣어 쓴다. 대본은 쓴 그대로 읽히므로 "차분하게 읽어 줘" 같은 지시를 대본 안에 쓰면 그 문장까지 소리로 나온다. 줄 전체의 태도는 speech_metadata의 style에, 짧은 웃음이나 쉼은 <laugh>, <short pause> 같은 태그로 넣는다는 점도 위 슈미트의 글에서 확인할 수 있다.
직접 해 볼 수 있는 확인은 같은 문장을 같은 음성 ID로 두 번 생성해 비교하는 것이다. 응답이 WAV 파일로 열리는지(구글 문서에 따르면 일반 응답은 44바이트 헤더가 붙은 WAV다), 미리듣기와 같은 사람처럼 들리는지, 긴 대본을 읽혀도 중간에 목소리가 바뀌지 않는지 본다. 헤더를 직접 붙이는 코드가 있으면 이중으로 붙지 않게 지운다.
제약도 알아 둔다. 한 요청에서 여러 화자를 쓰는 기능은 최대 2명이고 기본 제공 음성만 지원한다. 내가 만든 음성끼리 대화를 만들려면 화자별로 따로 생성해 오디오를 이어 붙인다. 구글 문서에 따르면 저장한 음성은 프로젝트당 200개까지, 1년 동안 쓰지 않으면 사라지고 사용할 때마다 기간이 다시 시작된다. store=False로 받은 키는 7일 뒤 만료된다.
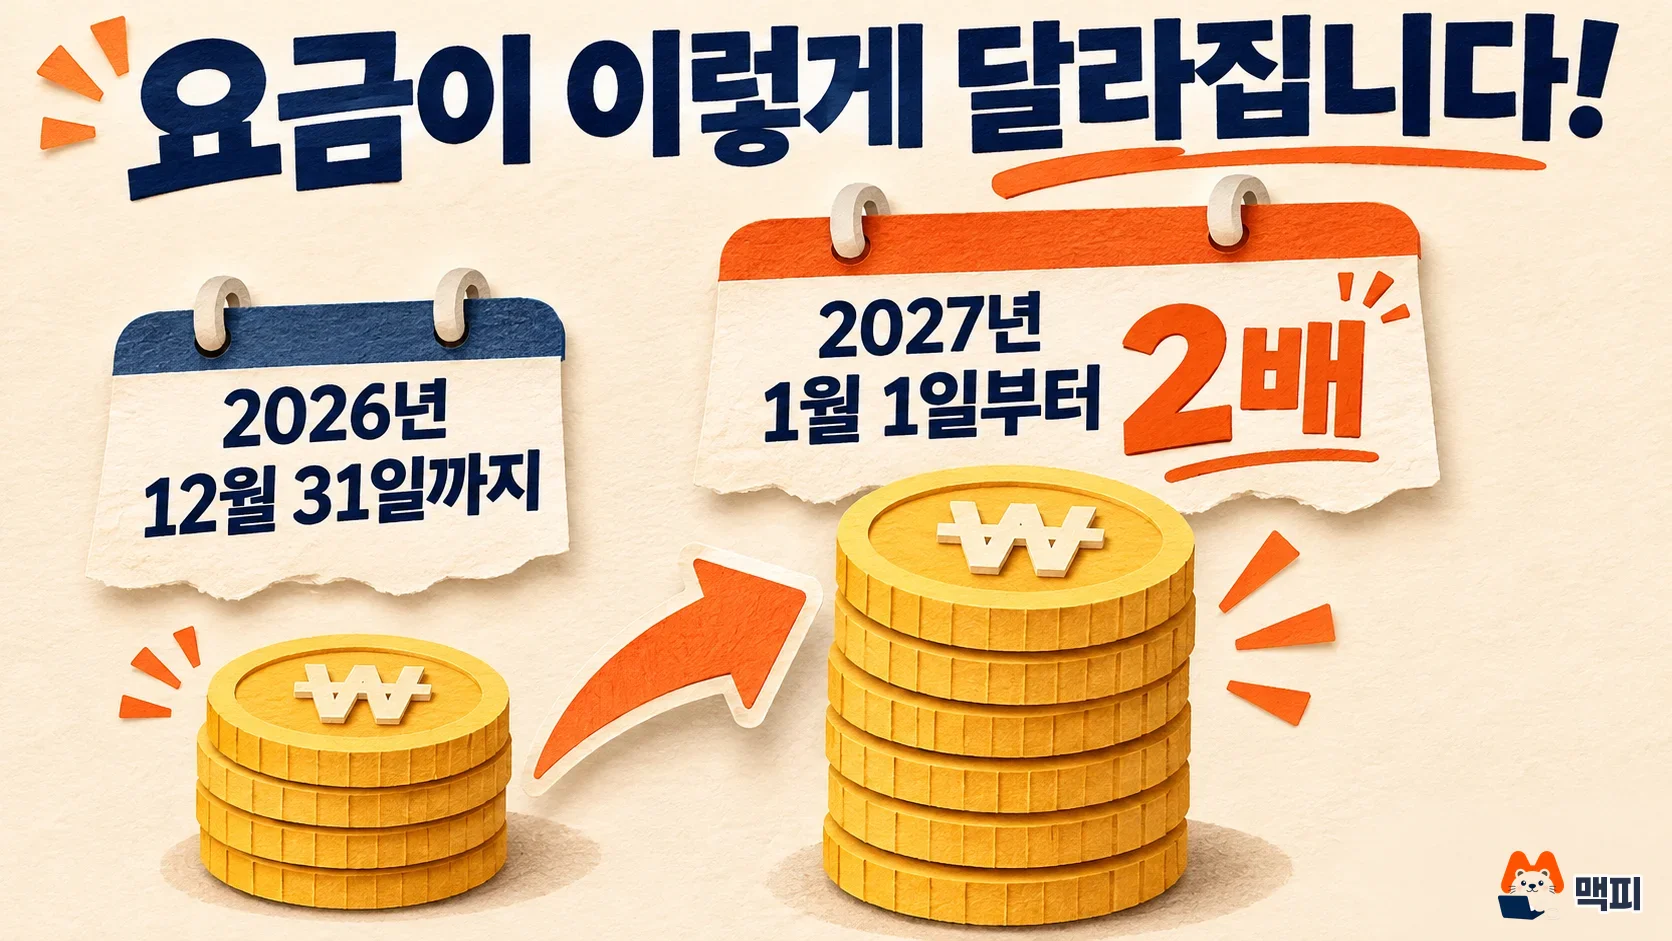
제미나이 TTS 요금: 12월 31일까지 절반 가격
구글 가격 문서에 따르면 두 모델 모두 무료 등급에서는 입출력이 무료다. 유료는 텍스트 입력 100만 토큰당 0.50달러, 오디오 출력은 Flash 9달러, Flash-Lite 6달러이고, 이 값은 2026년 12월 31일까지다. 2027년 1월 1일부터는 입력 1달러, 출력 Flash 18달러, Flash-Lite 12달러로 두 배가 된다. 원화 환산은 환율과 부가세에 따라 달라지므로 정산 전에 결제 화면의 금액으로 확인한다.
| 모델 | 2026년 12월 31일까지 | 2027년 1월 1일부터 |
|---|---|---|
| Flash TTS | 9 | 18 |
| Flash-Lite TTS | 6 | 12 |
장편 낭독을 대량으로 만들 계획이라면 가격이 오르기 전에 음성 ID를 정하고 시험해 두는 편이 낫다. 요금이 오르는 것은 생성 비용이고, 만들어 둔 음성 ID의 보관 조건은 위 저장 한도와 기간 그대로다.
자주 묻는 질문
제미나이 TTS 음성 복제는 다른 사람 목소리로도 되나요?
동의 녹음이 필요하므로 목소리 주인이 직접 동의 문장을 읽어야 한다. 참조 녹음과 동의 녹음은 같은 성인 화자여야 한다.
한국어로도 음성을 만들 수 있나요?
음성 생성은 Flash 130개 이상, Flash-Lite 100개 이상 언어를 지원하고, 복제용 동의 문장도 한국어가 포함된 30개 언어로 제공된다고 구글 문서에 적혀 있다.
구글 AI 스튜디오에서 코드 없이 쓸 수 있나요?
음성 디자인과 음성 복제 모두 AI Studio에서 만들 수 있다고 문서에 나와 있다. 복제는 화면에서 두 녹음을 올리거나 직접 녹음하고 미리 들은 뒤 ID를 복사한다.
같은 주제 글
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.