Knowledge Catalog 시맨틱 모델 지원은 여러 도구에 흩어진 지표 정의를 한 곳으로 모아 AI 에이전트가 같은 정의를 보게 하는 기능이다. 구글 클라우드는 2026년 10월 30일 공식 블로그에서 Looker, BigQuery, dbt, Snowflake, Databricks, SAP의 시맨틱 모델(지표와 비즈니스 용어의 정의) 지원이 정식 출시(GA)됐다고 발표했다.
무엇이 바뀌었나 여러 BI·데이터 도구에 흩어진 지표 정의를 Knowledge Catalog가 한 그래프로 가져와, AI 에이전트가 같은 정의를 참조한다.
누가 영향을 받나 위 여섯 도구 중 둘 이상에서 지표를 관리하고, AI 에이전트나 자연어 분석을 붙이려는 데이터·분석 담당자.
지금 할 일 지표 정의가 도구마다 다른지 먼저 점검하고, 소스를 연결해 충돌 목록을 확인한다.
Knowledge Catalog 시맨틱 모델 지원, 무엇이 바뀌었나
같은 "매출"이 대시보드에서는 환불 제외, 분석 쿼리에서는 환불 포함으로 계산돼 회의마다 숫자가 달라지는 일이 생긴다. 가게마다 "한 근"의 무게가 달라서 같은 고기를 사도 값이 다르게 나오는 것과 비슷하다. AI 에이전트도 어느 가게의 한 근인지 모르면 아무 숫자나 골라 답한다. 그래서 이번 발표는 에이전트가 SQL을 쓰기 전에 "검증된 정의"를 먼저 찾아보게 하는 방식이다. 다만 에이전트가 쓸 정의가 도구마다 다르면 이 연결만으로 숫자가 자동으로 맞춰지지는 않는다.
공식 블로그에 따르면 이번에 지원하는 소스와 가져오는 정보는 다음과 같다.
| 소스 | 가져오는 주요 정보 |
|---|---|
| Looker LookML | 모델, Explore, 뷰, 대시보드, 컴파일된 지표 SQL, 필수 필터, 조인 조건 |
| BigQuery Graph | 속성 그래프 정의, 노드·엣지 테이블, 그래프 지표, 비즈니스 동의어 |
| dbt MetricFlow | 지표, 소스와 모델 연결, 데이터 품질 테스트 결과, Saved Query, 신선도 SLA |
| Snowflake Semantic Views | 차원, 팩트, 지표 수식, 관계, 동의어, 품질 지표, PII 마스킹 태그(Horizon Catalog 경유) |
| Databricks Metric Views | 지표 뷰 정의, 측정값 수식, 조인 카디널리티, 인증 배지(Unity Catalog 경유) |
| SAP CSN | 비즈니스 레이블, 차원·큐브 모델링, 통화·단위 바인딩, 민감도 플래그(SAP Business Data Cloud 경유) |
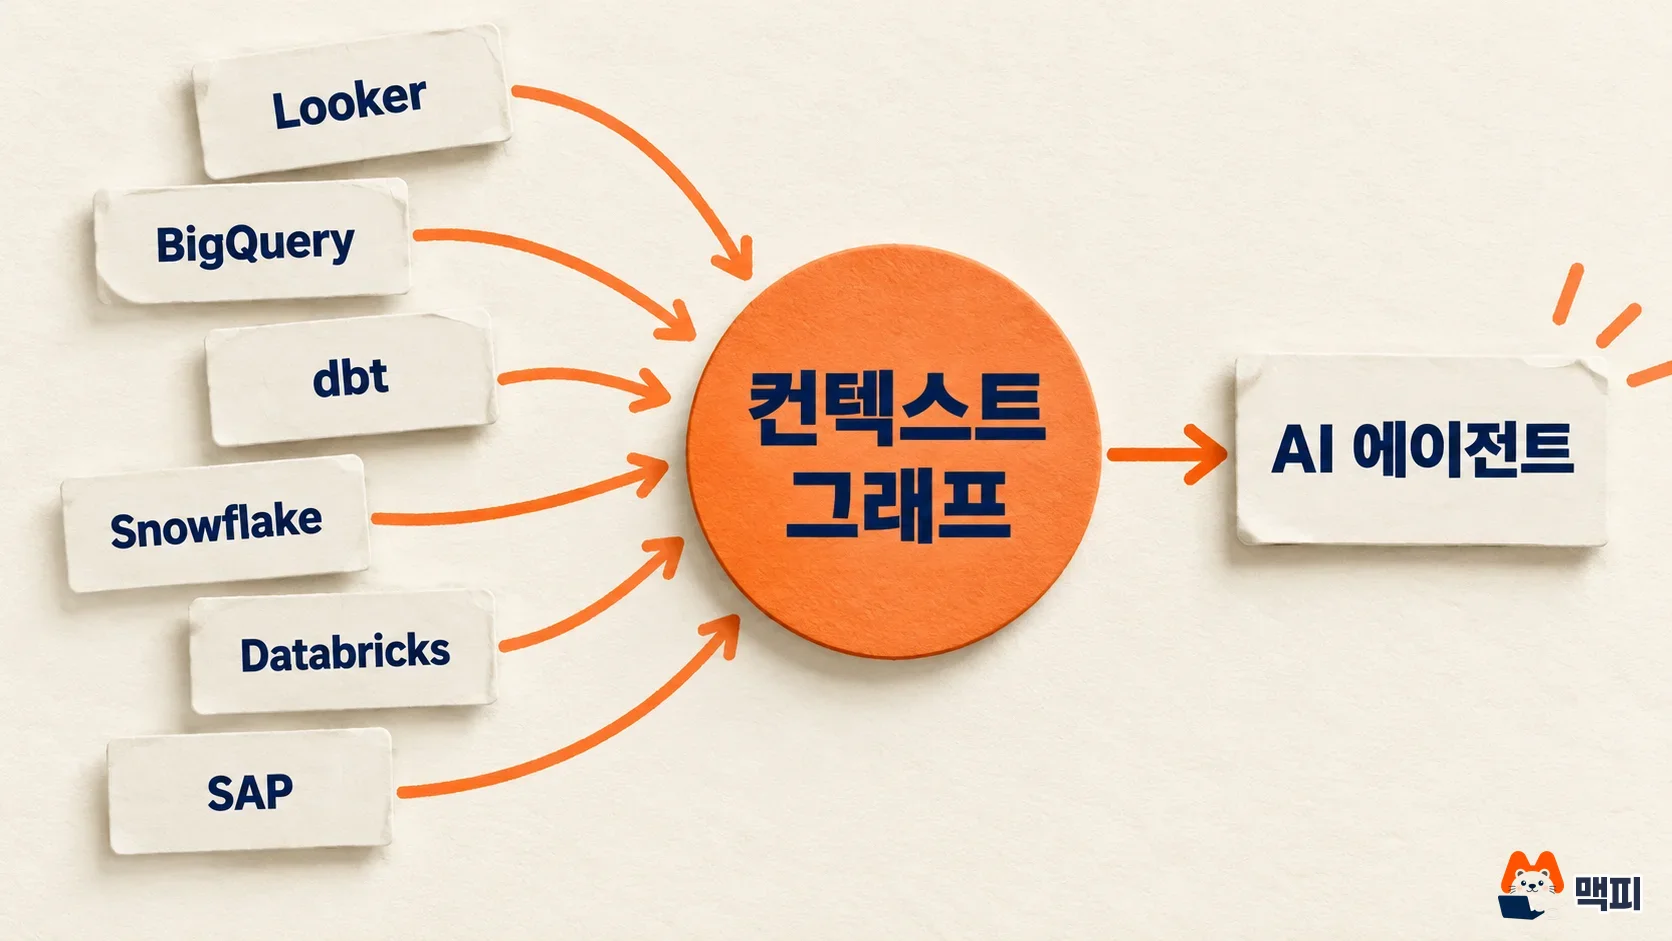
구글 블로그 설명으로는 데이터를 옮기거나 지표 로직을 다시 쓸 필요는 없고, 기존 정의를 Gemini Enterprise 에이전트, BigQuery Conversational Analytics, 직접 만든 에이전트에 연결하는 방식이다. Looker는 Looker Core의 Live sync로 연결한다. 일반 사용자용 에이전트가 궁금하면 제미나이 에이전트의 지원 앱과 비용 상한 글을 같이 보면 된다. BigQuery의 지표 정의가 궁금하면 BigQuery measures 설명 글을 먼저 보면 된다.
내 환경도 해당될까: 정의가 충돌하면 어떻게 보이나
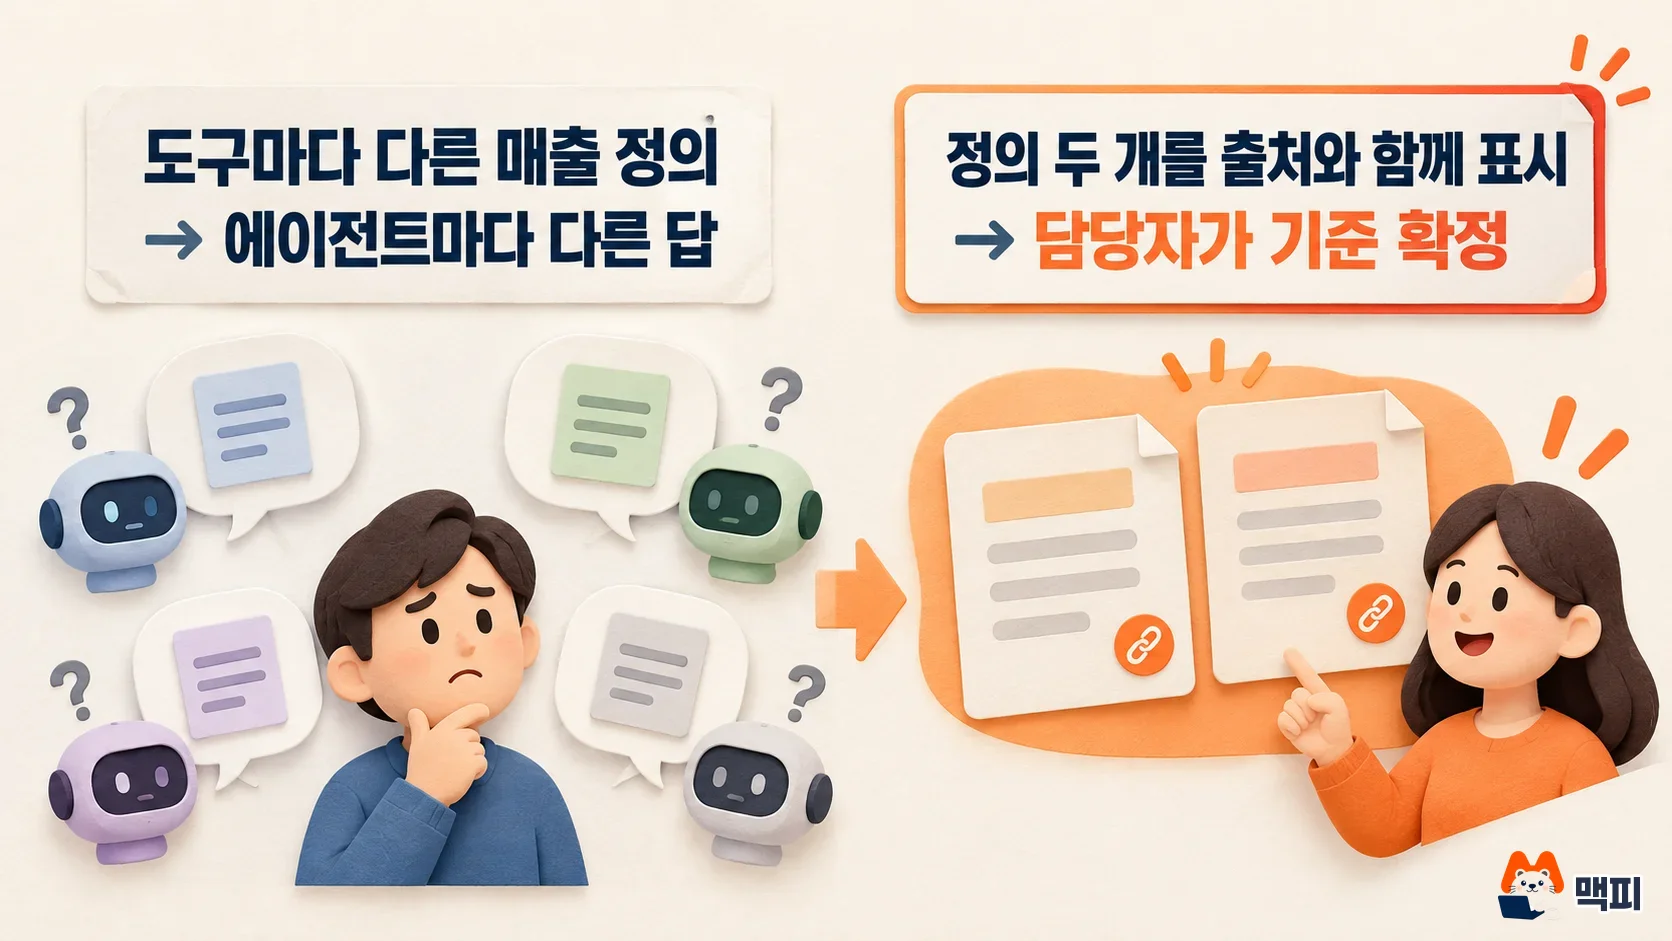
구글 공식 블로그에 따르면, 같은 지표가 도구마다 다르게 정의돼 있으면 Knowledge Catalog는 두 정의를 출처와 함께 모두 보여 주고, 기존 정의를 자동으로 덮어쓰지 않는다. 어느 쪽이 맞는지는 데이터 스튜어드(데이터 관리 담당자)가 정한다. 즉 이 기능은 충돌을 없애 주기보다 숨은 충돌을 드러내는 쪽에 가깝다.
같은 블로그는 데이터 품질 점수, 신선도, 리니지(데이터가 흘러온 경로)도 시맨틱 정의와 함께 제공해 에이전트가 믿을 만한 테이블인지 판단하게 한다고 설명한다. 또 Gemini가 운영 문서, 회의록, 채팅, 코드에서 빠졌거나 오래된 맥락을 찾아 정리해 주는 보강 기능도 소개했다. 구글은 이 구성으로 정확도가 약 4배 높아지고 지연 시간이 최대 33%, 토큰 사용이 최대 75% 줄었다고 밝혔지만 이는 구글 내부 벤치마크 수치라서 우리 환경에서는 다를 수 있다.
Knowledge Catalog 시맨틱 모델 연결하는 순서
블로그가 안내하는 흐름은 네 단계다. 먼저 Knowledge Catalog 문서를 따라 소스를 연결한다. Snowflake, Databricks, SAP는 각각 Horizon Catalog, Unity Catalog, SAP Business Data Cloud를 거치므로 해당 플랫폼 쪽 설정이 먼저 끝나 있어야 한다.
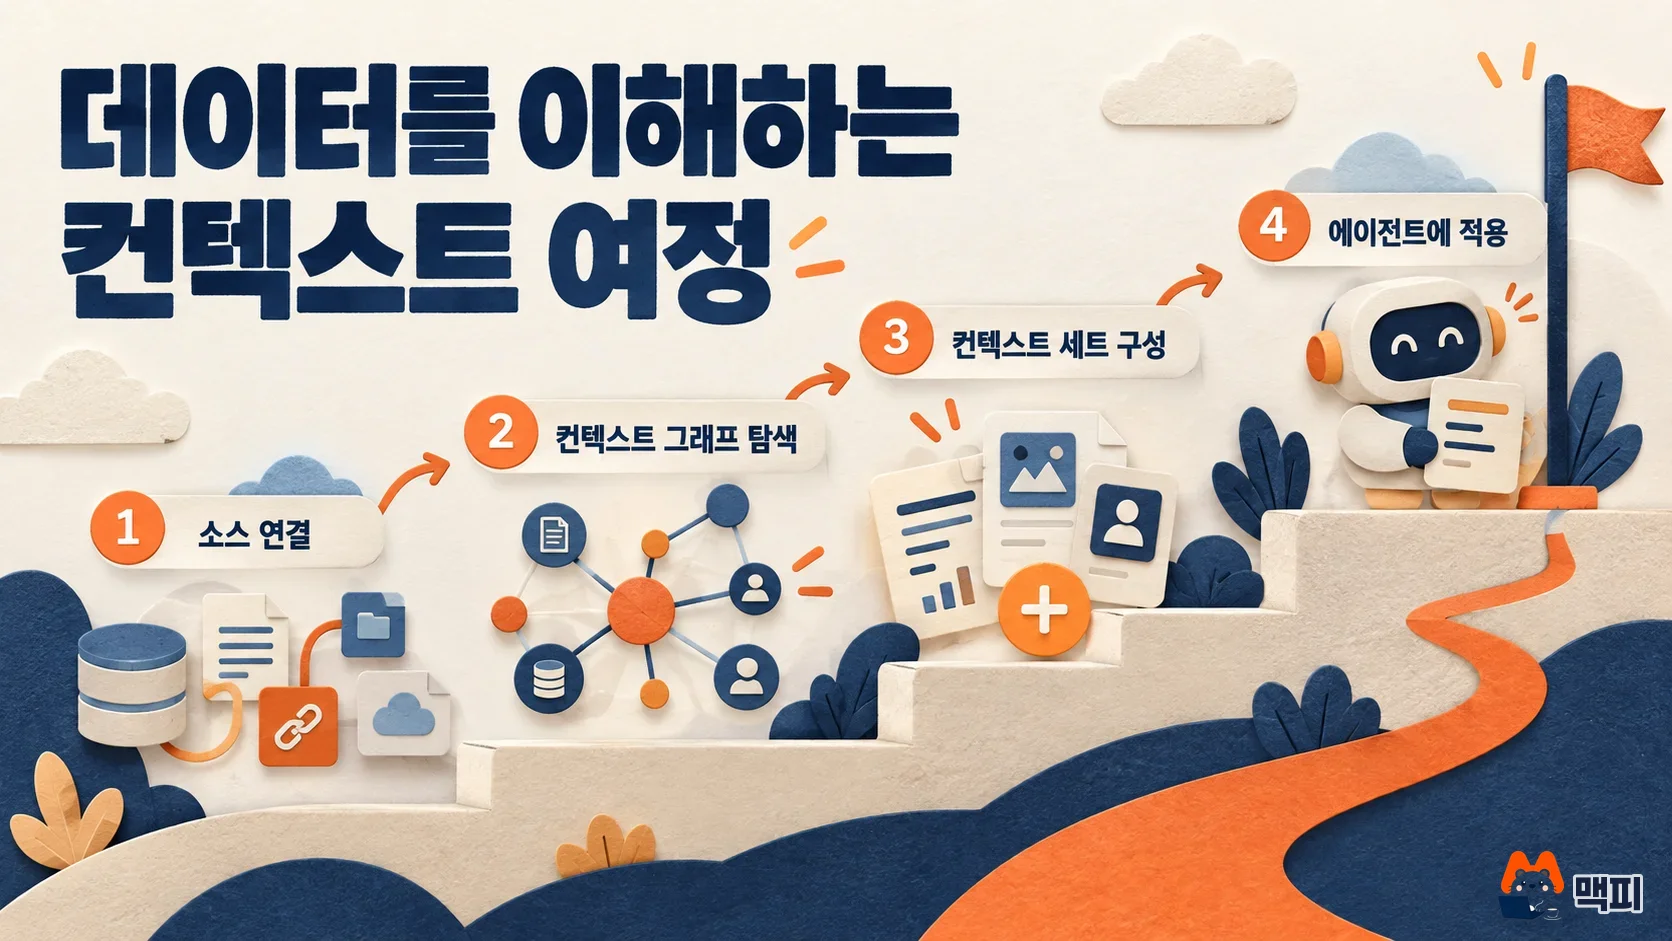
그다음 Knowledge Studio에서 자연어로 컨텍스트 그래프를 탐색한다. Knowledge Studio는 아직 미리보기이고 조직 단위로 사용 허용을 요청해야 하며, CMEK와 VPC Service Controls 등은 지원하지 않는다고 문서에 적혀 있다. 규제가 엄격한 환경이라면 정식 출시된 시맨틱 모델 연결과 미리보기 도구를 나눠서 판단해야 한다.
세 번째는 컨텍스트 세트다. 검증된 정의와 문서, 쿼리 템플릿을 사용 사례나 업무 영역별로 묶어 두는 단위로, 에이전트는 전체 카탈로그 대신 이 범위 안에서 근거를 찾는다. 만들려면 Dataplex Catalog Admin 같은 권한이 필요하고, 컨텍스트 세트 접근 권한만으로는 실제 BigQuery 테이블을 읽을 수 없어 데이터 권한이 따로 있어야 한다. 마지막으로 에이전트에 컨텍스트 세트를 지정하면 된다.
지금 할 일
공식 블로그가 제시한 순서는 연결과 탐색까지이고, 아래는 그 앞뒤를 채운 실무 순서다. 이미 위 도구 중 하나 이상으로 지표를 관리하고 있다면 다음 순서로 시작하는 것이 안전하다.
- 자주 쓰는 지표 5개(매출, 주문 수, 활성 사용자 등)를 골라 도구별 정의를 한 표에 적는다.
- Knowledge Catalog에 소스를 연결하고, 같은 지표에 정의가 둘 이상 뜨는지 확인한다.
- 충돌이 나온 지표는 담당자를 정해 기준 정의 하나를 승인하게 한다.
- 기준이 정해진 지표만 컨텍스트 세트에 담아 에이전트에 연결하고, 같은 질문의 답이 대시보드 숫자와 일치하는지 본다.
작게 확인하려면 "지난달 매출은?" 같은 질문 하나를 에이전트와 기존 대시보드에 똑같이 던져 본다. 두 숫자가 같고 답에 어느 정의를 썼는지 출처가 따라오면 연결이 된 것이고, 숫자가 다르면 3번 단계로 돌아가 충돌 정의를 다시 확인한다.
앞으로 확인할 점
한국어 질의에서 동의어와 한글 지표명이 잘 연결되는지, 리전 제약(리전 자산에 전역 컨텍스트 세트를 연결할 수 없음)이 우리 데이터 위치와 맞는지가 도입 전에 볼 대목이다. Knowledge Studio가 정식 출시되면 지원 범위가 달라질 수 있어 문서 변경을 확인해야 한다.
자주 묻는 질문
시맨틱 레이어와 컨텍스트 그래프는 무엇이 다른가요?
시맨틱 레이어는 지표와 용어의 정의 자체이고, 컨텍스트 그래프는 여러 도구의 정의를 품질·리니지 정보와 함께 연결해 에이전트가 따라가게 만든 구조다.
Looker를 안 쓰면 쓸 수 없나요?
아니다. dbt, Snowflake, Databricks, SAP, BigQuery Graph 중 어느 것이든 소스로 연결할 수 있다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.