AI 블로그 자동화의 비용은 글을 쓰는 모델보다 조사하는 동안 쌓이는 대화 크기에서 갈린다. 맥피가 같은 주제로 시험하니, 조사는 GPT-6.1 Sol이 맡아 근거 묶음(46줄)을 만들고 쓰기는 Claude Sonnet 5.5가 도구 없이 한 번에 하는 방식에서 쓰기 단계의 Claude 사용량이 호출 1회, 입력 2.3만 토큰, 출력 5.5천 토큰, 36초였다. Sonnet이 직접 조사하고 쓴 시험은 입력 12.1만 토큰이었다. 토큰은 모델이 글을 처리하는 단위이고, 입력은 모델에 보내는 양, 출력은 모델이 써 낸 양이다. 숫자는 맥피 블로그 필자를 2026년 10월 3일부터 6일까지 운영하며 잰 값이며, 기준일은 10월 6일이다.
AI 블로그 자동화에서 토큰이 쌓이는 이유
모델은 호출과 호출 사이에 기억이 없어서, 검색이나 페이지 읽기 같은 도구를 한 번 쓸 때마다 지금까지의 대화 전체를 다시 보낸다. Claude Code 비용 문서도 모든 요청에 전체 대화가 실리고 도구를 쓸 때마다 요청이 하나 더 생긴다고 설명한다. 그래서 비용은 호출 횟수에 그때까지 쌓인 대화 크기를 곱한 값에 가깝다.
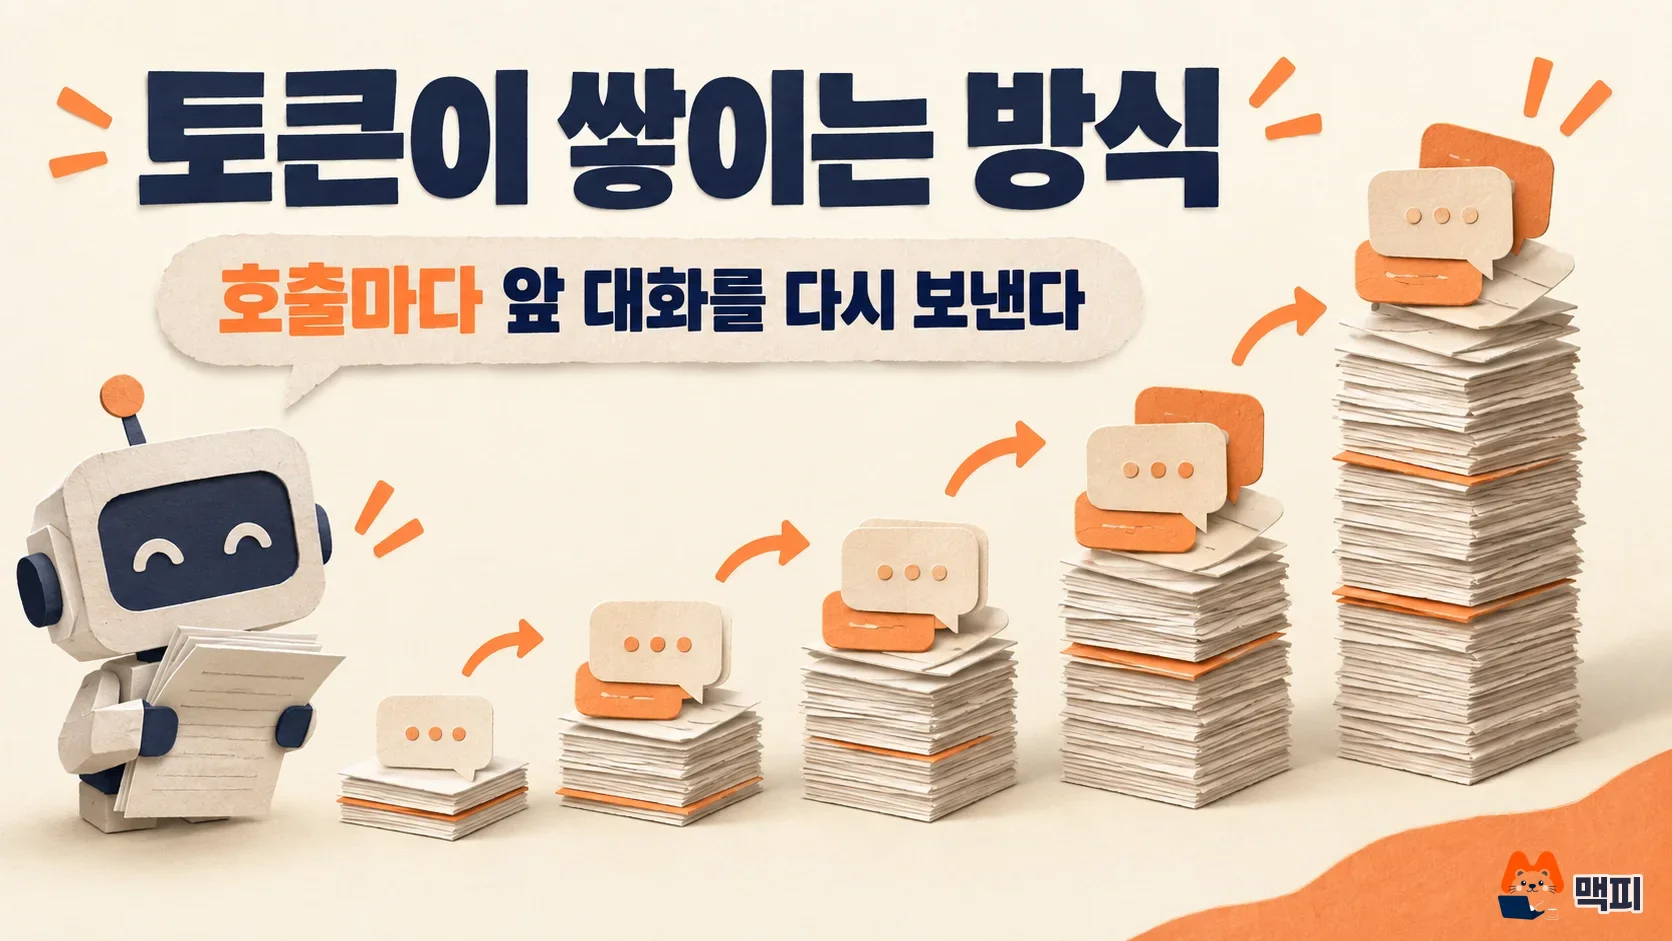
다시 보낸 앞부분은 서버가 저장해 둔 캐시(앞선 처리 결과의 재사용)로 읽어 값이 싸다. Anthropic 프롬프트 캐싱 문서는 캐시 읽기를 기본 입력 단가의 0.1배로, OpenAI 프롬프트 캐싱 문서는 GPT-6.1 Sol의 캐시 입력을 0.05배로 안내한다. 다만 싸다는 것이 없다는 뜻은 아니다. 맥피 실측에서 글 한 편은 모델을 23회 호출했고 캐시 재사용 합계가 147.6만 토큰이었으며, 새로 처리한 입력은 8.0만 토큰이었다.
그래서 출력만 줄여서는 한계가 있었다. 본문을 도구에 다시 쓰지 않게 해서 출력을 편당 5.7만에서 2.5만 토큰으로 줄였지만, 환산 비용은 2.57달러에서 2.13달러로 조금 줄었을 뿐이다. 비용 대부분이 캐시 재사용, 곧 입력 쪽이었기 때문이다.
조사와 쓰기를 나누면 품질과 토큰이 달라지는 정도
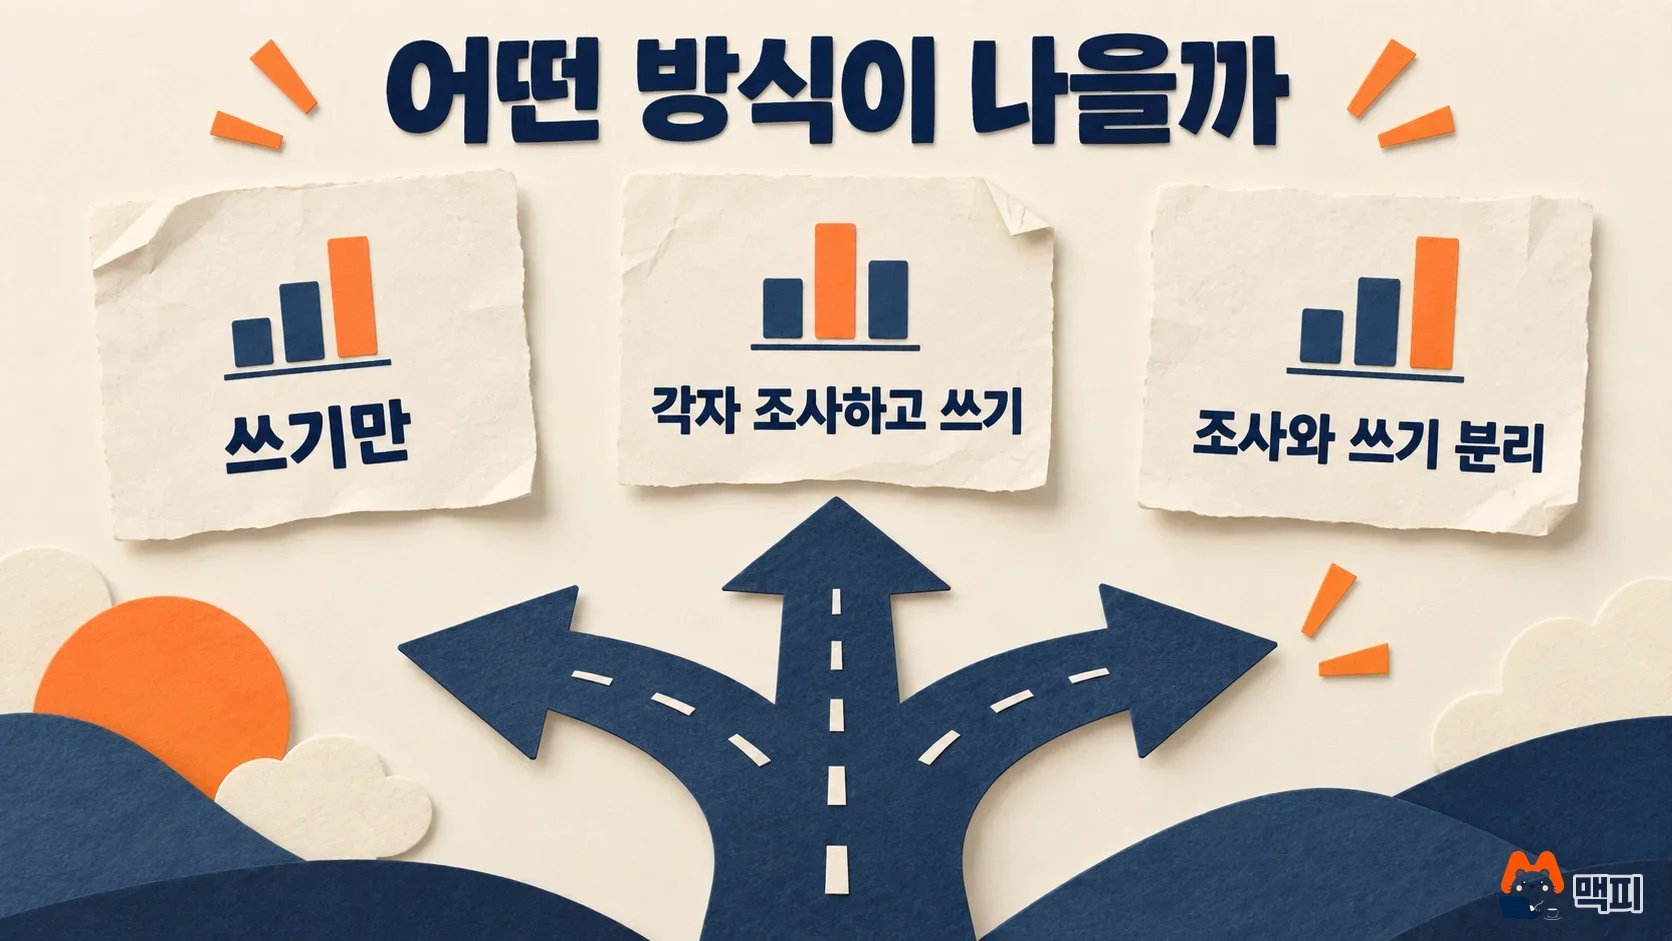
맥피는 세 가지 방식을 시험했다. 모델은 Claude Sonnet 5.5, gpt-6.1-sol, gpt-5.6-terra, gpt-6-luna이고, 판정은 사람의 블라인드 비교와 맥피 자체 품질 점수(문체·사실)를 함께 썼다. 1차는 같은 근거를 주고 쓰기만 시켰고, 2차는 모델마다 웹 조사부터 하게 했으며(주제는 루커 스튜디오), 3차는 조사와 쓰기를 나눴다.
| 시험 | 방식 | 토큰·시간 | 사람 판정 |
|---|---|---|---|
| 1차 | 같은 근거로 쓰기만 (Sonnet 5.5, gpt-6.1-sol, gpt-5.6-terra, gpt-6-luna) | 자체 품질 점수 문체 Sonnet 0.73, sol 0.71, terra 0.61, luna 0.60. 사실 점수는 0.87~0.89로 비슷 | Sonnet > terra = sol >> luna |
| 2차 | Sonnet이 직접 조사하고 쓰기 | 12턴, 링크 7개, 입력 12.1만, 출력 6.6천, 80초 | sol 우위 |
| 2차 | sol이 직접 조사하고 쓰기 | 웹 검색 16회, 링크 14개, 입력 39.9만(캐시 33.9만), 출력 3.4천, 173초 | sol 우위 |
| 3차 | sol이 근거 묶음 46줄을 만들고 Sonnet이 도구 없이 한 번에 쓰기 (쓰기 단계) | 입력 2.3만, 출력 5.5천, 36초, 호출 1회 | 이 방식과 sol 단독이 좋음 |
1차에서는 문체와 사람 판정 모두 Sonnet이 앞섰고, 사실 점수는 모델 간 차이가 거의 없었다. 2차에서 판정이 sol로 뒤집힌 것은 글솜씨 때문이 아니라 조사 깊이 때문이었다. sol은 링크를 14개 모았고 Sonnet은 7개였다. 3차는 이 둘을 합친 방식이다. 사람 판정은 더 자세하다는 평가와 함께 공식 용어가 어렵다는 지적을 받았다. 한 주제에 대한 소규모 시험이어서 모든 주제에 같은 결과가 나온다고 볼 수는 없다. 3차 표의 값은 쓰기 단계만의 것이며, 조사 단계에서 sol이 쓴 토큰은 이 표에 들어 있지 않다. 그래서 전체 비용이 줄었다고 단정하지 않고, 쓰기 쪽 대화가 짧아졌다는 사실까지만 말할 수 있다.
AI 글쓰기 조사와 쓰기를 나누는 방법
핵심은 조사 대화를 쓰기 대화로 끌고 오지 않는 것이다. 조사 모델이 공식 링크와 사실을 근거 묶음으로 정리하면, 쓰기 모델은 그 묶음만 받아 새 대화에서 한 번에 쓴다. 쓰기 쪽에는 검색 도구를 붙이지 않으므로 호출이 1회로 끝나고, 쌓이는 대화가 없다.
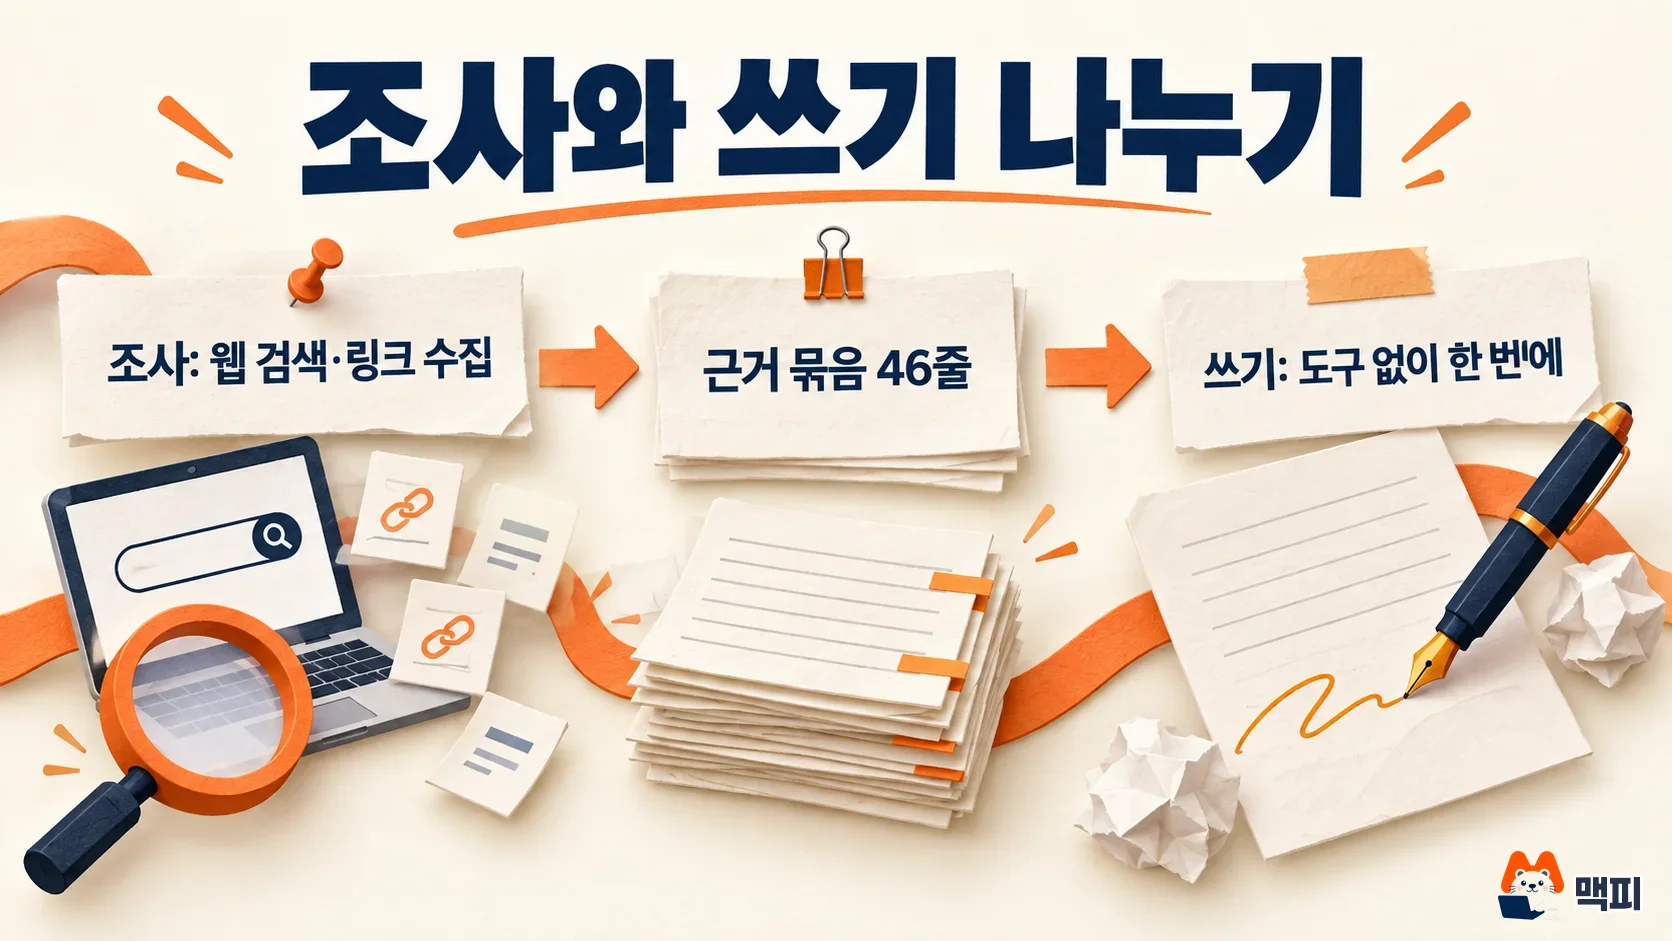
- 조사 모델에게 주제와 독자 질문을 주고, 사실마다 공식 링크를 붙인 근거 묶음을 만들게 한다. 맥피 시험의 묶음은 46줄이었다.
- 쓰기 모델에게는 근거 묶음, 문체 기준, 출력 형식만 준다. 도구는 붙이지 않는다.
- 결과물은 파일로 받아 기준 점검으로 넘긴다. 본문을 도구 입력에 다시 쓰지 않아야 출력도 줄어든다.
3차 평가의 약점이던 어려운 공식 용어는 쓰기 지시에 "공식 용어는 처음 나올 때 한 줄로 풀어 쓴다"를 넣어 줄일 수 있다. 이 지시는 맥피가 아직 시험하지 않은 보완안이다.
나누기 전에 대화에 쌓이는 불필요한 양부터 걷어 내는 것도 효과가 있었다. 맥피는 필자와 상관없는 도구 설명서 102개를 23개로, 검색량 조회 결과의 연관 검색어를 100개에서 20개로, 원본 크기 이미지 확인을 900px 축소본으로 바꿨다. 그 결과 쌓이는 최대 크기는 21만에서 12만 토큰으로, 편당 환산 비용은 1.89달러에서 1.43달러로 약 25% 줄었고 자체 품질 점수는 이전 범위(문체 0.77, 사실 0.85)에 머물렀다. 구독 로그인이라 이 금액이 실제로 청구되지는 않으며, Claude Code 비용 문서에 따르면 화면의 달러 값은 토큰 수를 정가로 계산한 추정치다.
AI를 여러 개 띄워 역할을 나누는 멀티 에이전트 방식은 오히려 더 쓸 수 있으니 주의해야 한다. Anthropic의 멀티 에이전트 리서치 시스템 글은 에이전트가 일반 채팅의 약 4배, 멀티 에이전트가 약 15배의 토큰을 쓴다고 밝혔다. 나누기의 이득은 에이전트를 늘리는 데서 나오지 않고, 쓰기 단계의 대화를 짧게 끊는 데서 나온다. 사용량 한도 자체가 궁금하면 클로드 코드 설치와 요금제, 사용량 한도 정리를 먼저 보면 된다.
클로드 vs GPT, 조사와 쓰기에 무엇을 쓸까
맥피 시험 기준으로 문장 결과 사람 판정은 Sonnet 5.5가, 조사 깊이는 gpt-6.1-sol이 앞섰다. 그래서 조사에는 sol, 쓰기에는 Sonnet을 권한다. 이 권고는 한 주제의 시험에 근거하므로 주제가 달라지면 같은 방식으로 다시 비교해 보는 편이 안전하다.
가격 면에서는 두 모델이 비슷하다. OpenAI 모델 페이지의 GPT-6.1 Sol은 100만 토큰당 입력 2달러, 캐시 입력 0.1달러, 출력 10달러이고, 한 번에 읽을 수 있는 최대 길이(컨텍스트 윈도우)는 105만 토큰이다. Anthropic 가격표의 Claude Sonnet 5.5도 입력 2달러, 캐시 읽기 0.20달러, 출력 10달러다(자세한 특징은 클로드 소넷 5.5 API 정리). 입력과 출력 단가가 같으니 차이는 호출 횟수와 쌓이는 대화 크기에서 난다.
내 자동화에서 토큰이 새는지 확인하는 위치
Claude Code를 쓴다면 세션에서 /usage를 실행해 Session 블록의 토큰 사용량을 본다. Claude Code 비용 문서에 따르면 이 블록은 입력, 출력, 캐시 읽기, 캐시 쓰기 토큰을 모델별로 보여 준다. 캐시 읽기가 입력보다 몇 배 크다면 대화가 길게 쌓여 있다는 신호다. Claude Code v2.1.251 이상에서는 같은 블록의 Prompt cache (main) 줄에서 캐시 적중 비율도 볼 수 있다.
나눈 뒤에는 같은 주제로 두 방식을 한 번씩 돌려 쓰기 단계의 호출 횟수와 입력 토큰이 줄었는지 비교한다. 호출이 1회에 가깝고 입력이 조사 포함 방식보다 작아졌다면 분리가 효과를 낸 것이다. 그다음 품질 점검을 통과하는지 확인해, 줄어든 만큼 글이 얕아지지 않았는지 본다.
자주 묻는 질문
서브에이전트(맡은 일 하나만 하는 보조 AI)를 쓰면 토큰이 줄어드나요?
메인 대화에는 요약만 돌아와 쌓이는 양이 줄지만 서브에이전트의 요청도 사용량에 잡힌다. Claude Code 비용 문서는 긴 출력을 서브에이전트 안에 가두고 요약만 받도록 권하면서, 서브에이전트의 요청은 따로 사용량을 쓴다고 밝힌다.
구독으로 쓰는데 왜 달러 금액이 표시되나요?
Claude Code가 토큰 수를 정가로 계산해 보여 주는 추정치다. 같은 문서는 Max와 Pro 구독자는 사용량이 구독에 포함되어 청구에는 의미가 없다고 설명한다. 구독 한도에서 차감되는 양을 가늠하는 용도로 보면 된다.
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.