AI 에이전트 오케스트레이션은 여러 AI 작업의 순서와 역할을 정하는 설계다. 오래 이어 가는 대화 하나에 맡기면 사용량이 빠르게 불어나서, 맥피는 작업 장부와 짧은 세션으로 나누어 운영한다. 모델은 호출 사이에 기억이 없어 도구를 한 번 부를 때마다 지금까지의 대화 전체를 다시 보내기 때문이다. 아래에서 맥피의 실측 수치(2026년 10월 3일부터 6일), 설계 순서, 서브에이전트와 멀티 에이전트를 쓰는 기준을 Anthropic 공식 글과 함께 정리한다. AI 에이전트의 기본 개념부터 확인한 뒤 읽으면 이해가 쉽다.
AI 에이전트를 오래 쓰는 대화로 돌리면 왜 비싼가
도구를 호출할 때마다 앞의 대화 전체가 다시 전송되므로, 비용은 호출 횟수에 그때까지 쌓인 대화 크기를 곱한 값에 가깝다. 다시 보내는 앞부분은 서버가 캐시로 재사용하기 때문에 새로 처리하지는 않는다. Anthropic 문서에 따르면 캐시 읽기 토큰은 기본 입력 가격의 0.1배이고 기본 수명은 5분이다. 단가는 낮지만 재사용한 양도 사용량으로 잡힌다.
이 차이는 맥피의 운영 기록에서 크게 드러났다. 맥피는 블로그 필자를 Claude Code(헤드리스 실행)로 매시간 돌린다. 사람과 AI가 며칠째 이어 온 대화 하나는 답변 한 번마다 캐시 재사용이 약 82만 토큰이었다. 01:45부터 02:50 사이 이 대화의 답변 25회가 2,033만 토큰을 썼고, 같은 시간에 필자가 쓴 글 12편은 1,834만 토큰이었다. 글 12편보다 대화 25번이 더 많이 쓴 셈이다.
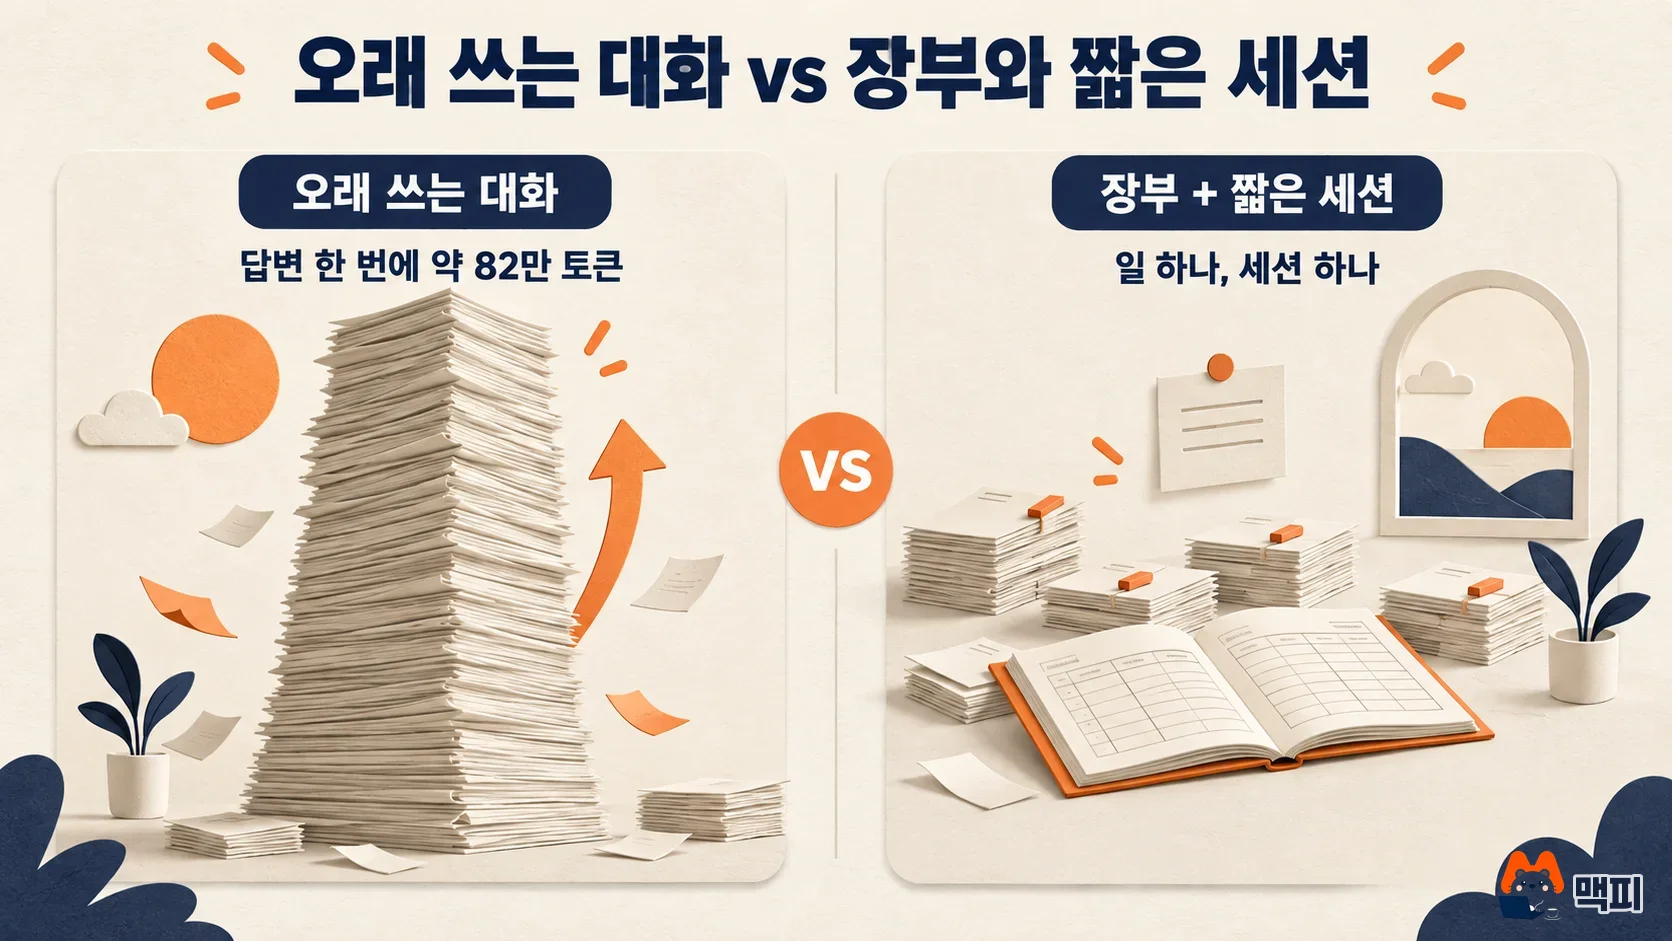
다른 업무에서도 같은 모양이 나왔다. 10일 이어진 오케스트레이터 대화는 1,847회 호출, 지금 한 번에 약 93만 토큰, 캐시 재사용 누적 9.7억 토큰이었다. 서브에이전트에 132회 위임했지만 결과가 오케스트레이터 대화에 그대로 쌓였고 자동 압축은 4번 일어났다. 17일 이어진 디자인 대화는 744회 호출에 누적 3.5억 토큰이었고 서브에이전트 위임은 0회였다.
자동 압축이 해결책이 되지 못한 이유는 압축이 상한(약 100만 토큰)에 닿을 때 줄여 줄 뿐 다시 차오르는 것을 막지 못하기 때문이다. Anthropic은 컨텍스트 엔지니어링 글에서 컨텍스트 윈도우의 토큰이 늘수록 모델이 그 안의 정보를 정확히 떠올리는 능력이 떨어진다고 설명한다. 대화를 길게 끌면 사용량만 늘어나는 것이 아니라 정보를 정확히 떠올리는 능력도 떨어질 수 있다.
AI 에이전트 오케스트레이션 설계: 장부, 프로그램, 짧은 세션
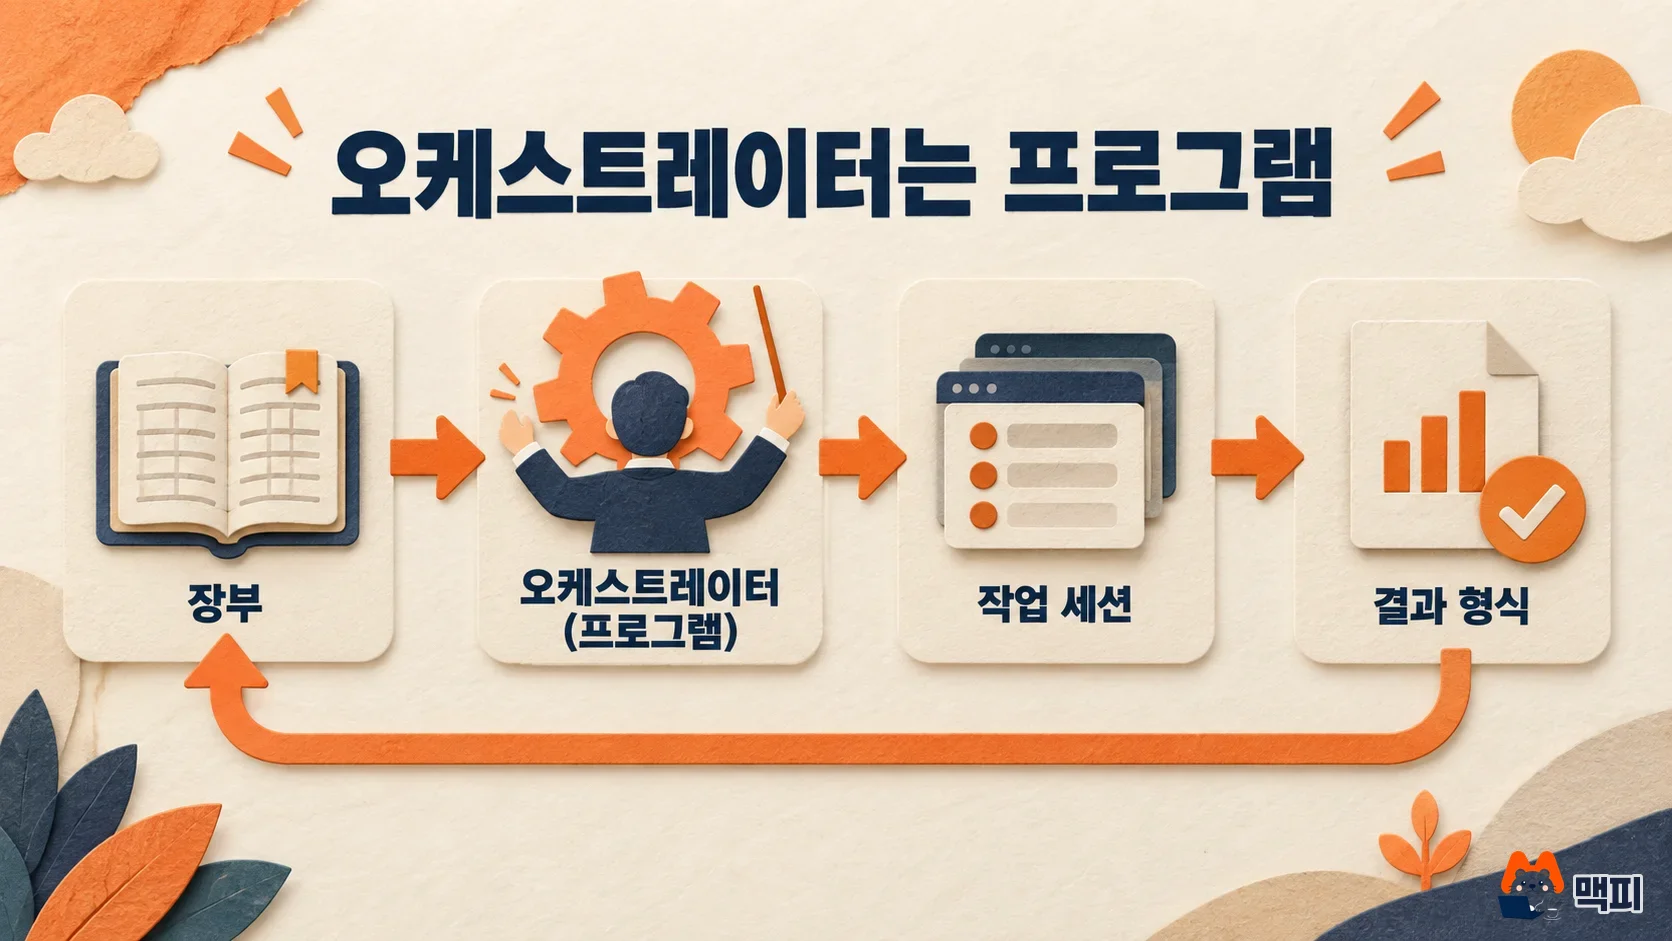
설계의 뼈대는 세 가지다. 상태는 장부(데이터베이스나 문서)에 두고, 순서는 프로그램이 정하고, 실제 일은 한 번 쓰고 버리는 짧은 세션이 한다. Anthropic의 장시간 에이전트 운영 글은 새 세션이 이전 기억 없이 시작한다는 점을 전제로 한다. 그래서 진행 기록 파일, 기능 목록, git 커밋을 남기고 세션마다 한 번에 하나의 기능만 처리하게 하며, 세션을 시작할 때는 진행 파일과 git 기록을 읽고 미완료 항목 중 우선순위가 높은 것을 고르게 한다.
| 구성 요소 | 하는 일 | 두지 말아야 할 것 |
|---|---|---|
| 장부 | 할 일, 상태, 결과 요약, 사람 확인 표시를 저장 | 대화 전문 보관 |
| 오케스트레이터 | 장부에서 할 일을 고르고 필요한 문서만 묶어 새 세션을 띄움 | AI 대화로 운영(순서는 프로그램이 정함) |
| 작업 세션 | 일 하나만 하고 끝남. 그 일에 필요한 모델과 도구만 붙임 | 여러 일을 이어서 처리 |
| 사람과의 대화 | 목표, 결정, 확인만 다룸 | 작업 내용 전체 |
오케스트레이터를 AI 대화로 두지 않고 프로그램으로 두는 것이 이 설계의 핵심 선택이다. 맥피는 순서를 정하는 데 모델의 판단이 필요 없는 일이라면 프로그램이 장부를 읽어 다음 일을 고르게 한다. 순서를 고르는 동안 대화가 쌓이지 않기 때문이다. Anthropic의 Building effective agents는 미리 정해진 코드 경로로 모델과 도구를 엮은 것을 워크플로, 모델이 스스로 처리 과정과 도구 사용을 지휘하는 것을 에이전트로 구분한다. 필요한 세부 작업을 미리 예측할 수 없는 복잡한 일에는 중앙 모델이 작업을 나누어 맡기는 orchestrator-workers 방식이 알맞다고 설명한다. 반복되는 업무는 대부분 순서를 미리 알 수 있으므로 프로그램으로 충분하다.
서브에이전트와 멀티 에이전트는 언제 쓰나
서브에이전트는 따로 떨어진 컨텍스트 윈도우에서 일하고 요약만 돌려주는 보조 에이전트이므로, 탐색 결과나 로그가 메인 대화를 채울 일을 떠넘길 때 쓴다. Claude Code 문서에 따르면 서브에이전트는 자체 컨텍스트 윈도우, 지정한 시스템 프롬프트, 제한된 도구 접근과 별도 권한으로 실행되고, tools 필드로 쓸 도구를, model 필드로 모델을 정할 수 있다. 여러 파일을 뒤져 결과만 알려 달라는 일이 대표적이다. 서브에이전트를 다룬 사례는 Claude Code 서브에이전트로 CRM 설명서 만든 글에 있다.
멀티 에이전트는 비용이 크다는 점을 먼저 따져야 한다. Anthropic의 멀티 에이전트 리서치 시스템 글에 따르면 에이전트는 채팅보다 토큰을 약 4배, 멀티 에이전트 시스템은 약 15배 쓴다. 그래서 작업의 가치가 그만큼 높고 여러 갈래를 동시에 탐색하는 일에 맞다. 같은 글은 서브에이전트마다 목표, 출력 형식, 쓸 도구와 출처에 대한 안내, 작업 경계를 알려 주라고 한다. 이것이 빠지면 서로 같은 일을 하거나 필요한 정보를 놓친다.
서브에이전트를 쓰는 것만으로는 부족하다는 점이 맥피의 실측에서 나왔다. 132회 위임한 오케스트레이터 대화는 결과가 대화에 그대로 쌓여 여전히 93만 토큰까지 커졌다. Anthropic의 컨텍스트 엔지니어링 글은 서브에이전트가 보통 1,000~2,000 토큰으로 압축한 요약만 돌려주는 구조를 설명한다. 위임 결과를 요약 형식으로 제한하고, 긴 산출물은 파일에 두고 경로만 받아야 위임이 효과가 있다.
작업 세션 결과 형식 만들기와 확인 방법
작업 세션이 끝나면 장부에 쓸 결과의 형식을 고정한다. 맥피는 다섯 가지를 쓴다.
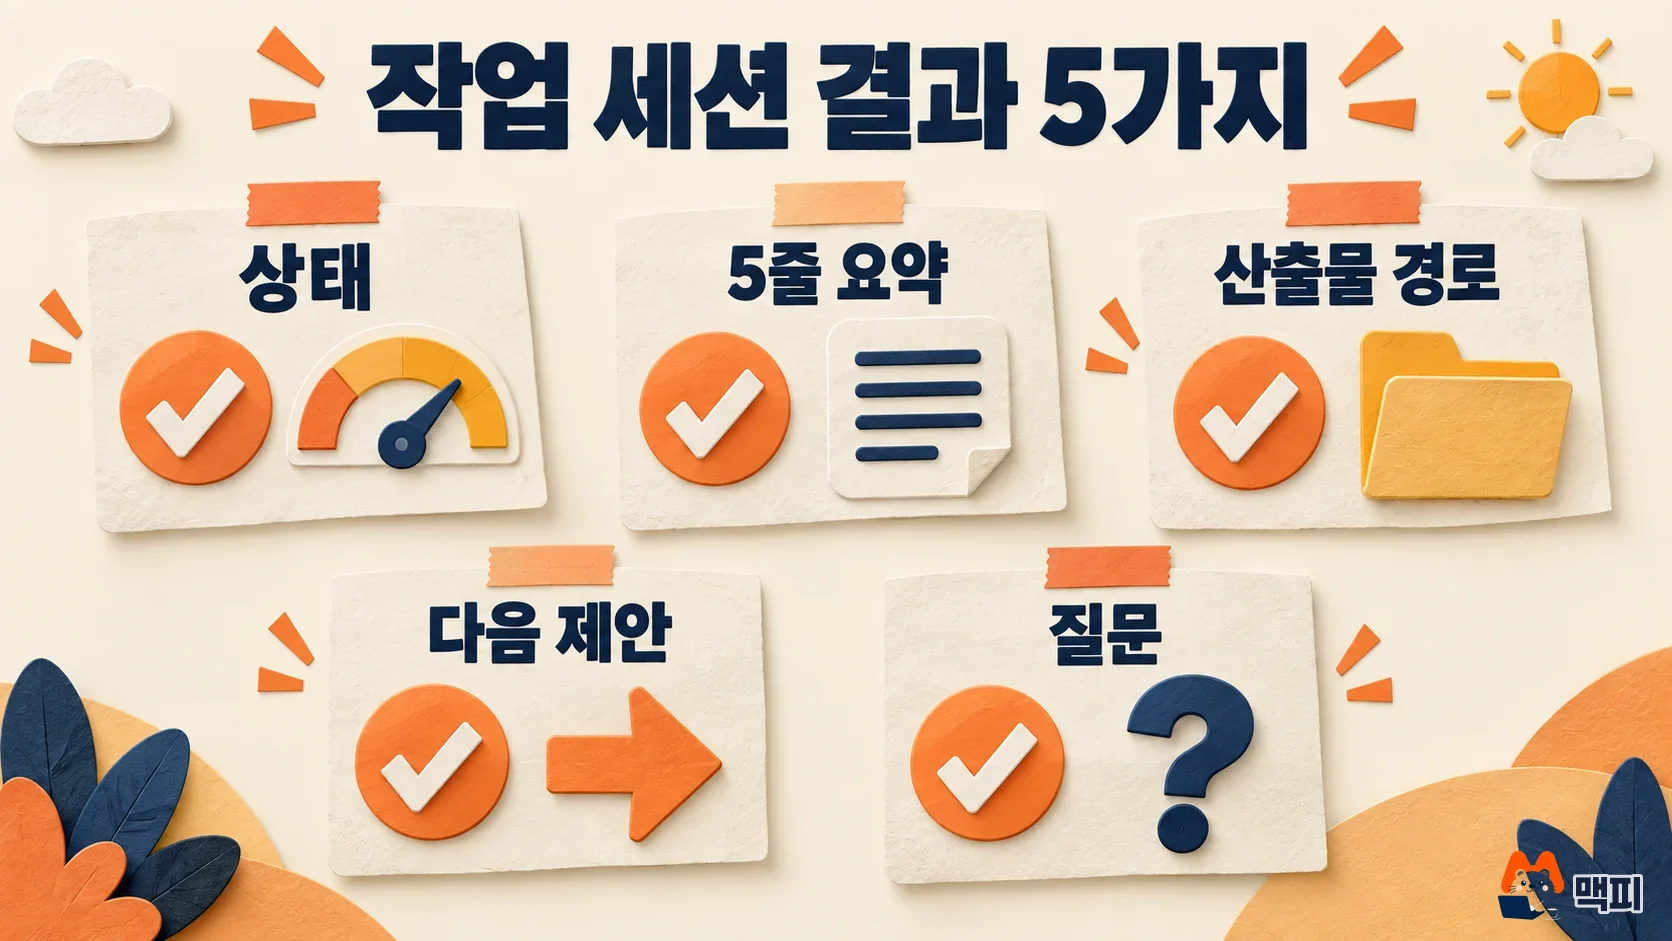
- 상태: 끝남, 막힘, 사람 확인 필요 중 하나.
- 5줄 요약: 무엇을 했는지와 결과.
- 산출물 경로: 긴 내용은 파일에 두고 경로만 적는다.
- 다음 제안: 이어서 할 일 후보.
- 질문: 사람이 정해야 할 것.
검수는 두 단계로 나눈다. 테스트, 렌더, 평가처럼 정해진 관문을 먼저 통과시키고, 사람의 판단 같은 판단 검수만 새 세션에 맡긴다. 사람 확인이 필요한 항목은 장부에 표시해 텔레그램이나 허브로 묻는다. 사람과의 대화는 목표, 결정, 확인만 하고, 작업 내용은 장부와 산출물 파일을 보게 한다.
제대로 돌아가는지는 다음 세 가지로 점검한다. 첫째, 작업 세션이 시작할 때 읽는 문서가 그 일에 필요한 것뿐인지 본다. 둘째, 한 세션의 마지막 컨텍스트 크기가 세션마다 비슷한 수준에서 끝나는지, 하루가 지나도 계속 커지지 않는지 본다. 셋째, 장부만 읽어도 지금 어디까지 했고 사람이 무엇을 정해야 하는지 알 수 있는지 본다. 이 셋이 되면 대화 하나에 의존하지 않는 구조다.
맥피 필자 운영에 적용한 결과
맥피의 블로그 필자는 이 방향으로 조금씩 바뀌어 왔다. 대기열 파일, 사전 확인(precheck), 글마다 새 세션, 파일 경로로 저장하는 명령, 품질 관문, 텔레그램, 병렬 실행이 그 변화다. 10월 3일부터 5일까지 사흘간 필자는 103회 실행됐고, Claude Code가 표시한 API 환산 금액 합계는 약 243달러였다. 구독 로그인이라 실제 청구는 없고 구독 사용 한도에서 차감되며, 표시 금액은 같은 양을 API로 썼을 때의 환산이다.
필자 한 편 안에서 쌓이는 양을 줄이는 조치도 같은 원칙이었다. 필자와 상관없는 도구 설명서 102개가 매 호출에 실리던 것을 필요한 23개만 남겼고, 검색량 조회 결과의 연관 검색어 100개를 20개로, 중복 확인 결과는 다른 글 본문 전체에서 제목과 요약으로, 원본 크기 이미지 확인은 900px 축소본으로 줄였다. 할 일이 없을 때도 매시간 돌던 실행은 할 일이 있을 때만 돌게 바꿨다. 새 설정의 첫 글에서 쌓이는 최대 크기는 21만에서 12만 토큰, 평균은 16만에서 9.5만 토큰이 됐고, 편당 환산 비용은 1.89달러에서 1.43달러로 약 25% 줄었다. 품질 점수는 이전 범위(문체 0.77, 사실 0.85)를 유지했다.
| 구분 | 조치 전 | 조치 후 |
|---|---|---|
| 최대 크기 | 21만 | 12만 |
| 평균 크기 | 16만 | 9.5만 |
출력만 줄이는 것으로는 효과가 작았다. 본문을 도구에 다시 쓰지 않게 한 첫 조치로 출력이 편당 5.7만에서 2.5만 토큰으로 줄었지만 환산 비용은 2.57달러에서 2.13달러로 조금만 내려갔다. 비용 대부분이 캐시 재사용이었기 때문이다. 사용량 한도가 걱정이라면 클로드 코드 요금제와 사용량 한도도 함께 본다.
AI 에이전트 오케스트레이션, 오늘 시작하는 순서
오늘 바로 할 일은 두 가지다. 가장 오래 이어 온 대화 하나를 골라 결정과 남은 일을 문서 한 장에 옮기고 그 대화를 닫는다. 그다음 새 세션에 그 문서만 읽혀 같은 일을 이어 가게 하고, 시작할 때 읽는 양이 이전 대화보다 얼마나 작은지 비교한다.
자주 묻는 질문
AI 오케스트레이션과 멀티 에이전트는 같은 말인가요?
다르다. 오케스트레이션은 여러 작업의 순서와 역할을 정하는 일이고, 멀티 에이전트는 에이전트 여러 개가 나눠 일하는 구조다. 오케스트레이션은 에이전트 없이 프로그램만으로도 할 수 있다.
서브에이전트를 쓰면 토큰이 줄어드나요?
메인 대화에 탐색 결과가 쌓이지 않으면 줄지만, 위임 결과가 길게 돌아오면 줄지 않는다. 맥피의 오케스트레이터는 서브에이전트에 132회 위임했는데도 결과가 대화에 쌓여 한 번에 약 93만 토큰까지 커졌다.
작업 장부는 무엇으로 만들면 되나요?
데이터베이스나 문서 한 개면 된다. Anthropic의 장시간 에이전트 글도 진행 기록 파일과 기능 목록 파일, git 커밋으로 상태를 남긴다. 중요한 것은 도구가 아니라 새 세션이 읽고 바로 이어서 일할 수 있는 형식이다.
근거 자료
이 글이 도움이 되었다면 공유해주세요
관련 인사이트
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.