구글 클라우드 Knowledge Catalog의 자가학습 컨텍스트 보강은 AI 에이전트가 사용자와 나눈 대화에서 빠졌거나 오래된 데이터 설명을 찾아 고쳐 주는 기능으로, 2026년 10월 23일 프리뷰로 공개됐다. 구글 클라우드는 이 기능이 몇 주 안에 고객에게 순차 제공된다고 공식 발표에서 밝혔다. 같은 날 시각적으로 컨텍스트를 검토하는 Knowledge Studio도 프리뷰로 나왔다.
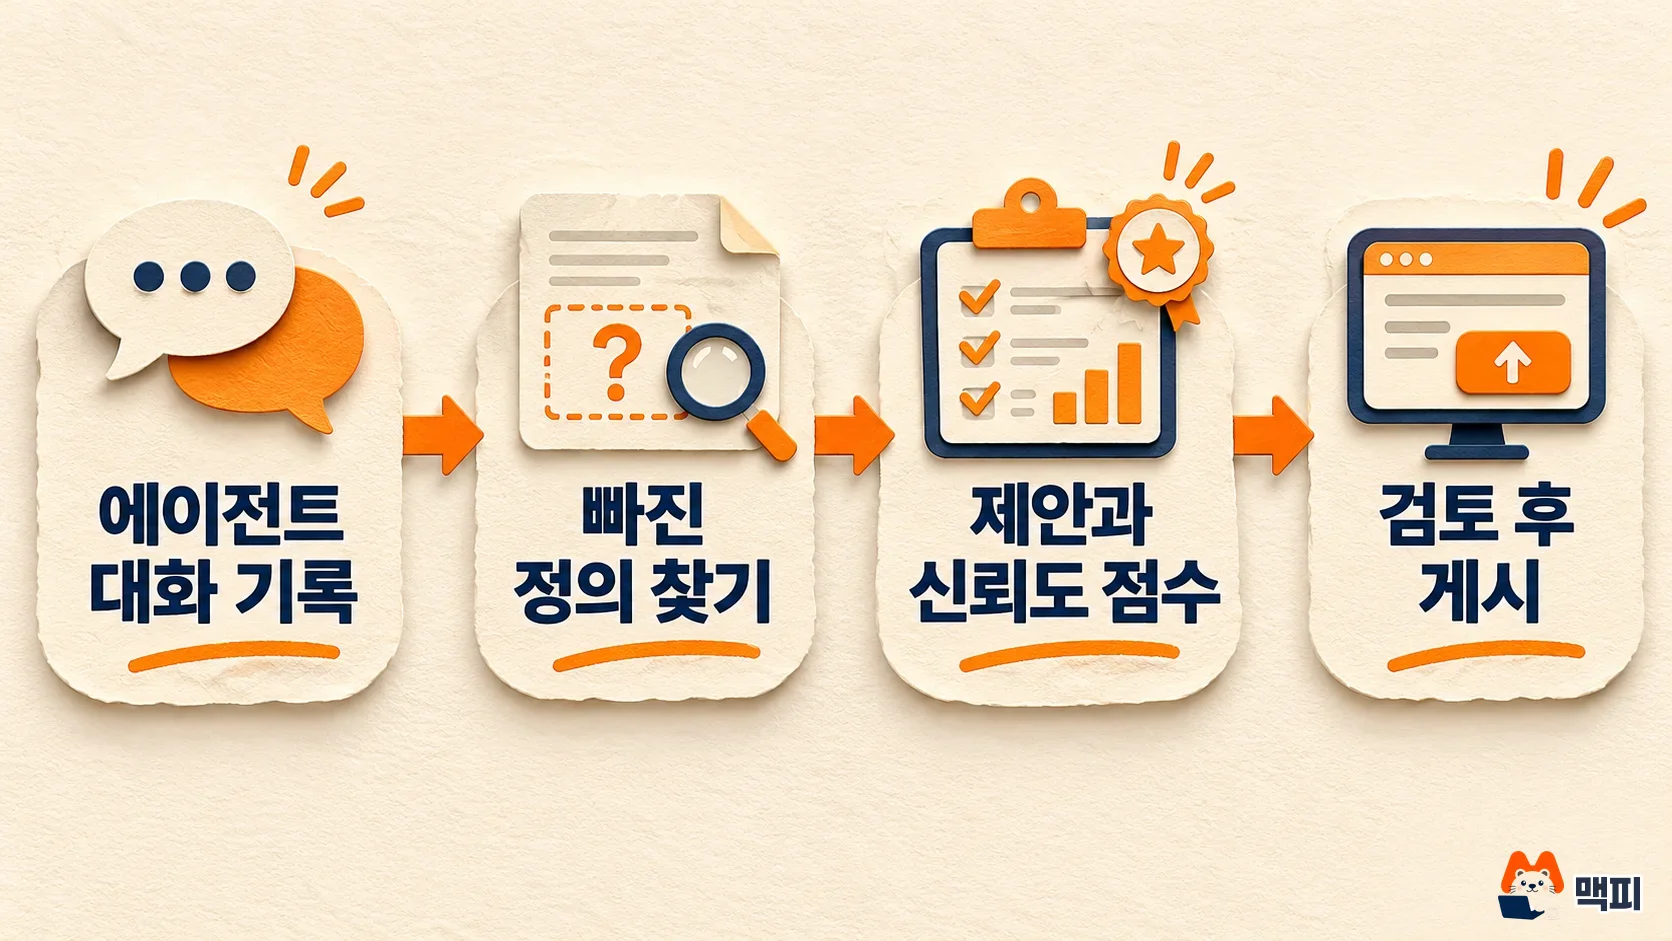
무엇이 바뀌었나 에이전트 대화 기록에서 누락된 데이터 정의를 찾아 제안하고, 담당자가 승인하면 반영하는 기능이 프리뷰로 추가됐다.
누가 영향을 받나 구글 클라우드에서 BigQuery 등의 데이터를 에이전트나 자연어 분석에 연결해 쓰는 데이터 담당자다.
지금 할 일 에이전트가 자주 틀리는 지표 정의를 정리하고, 자동 게시 신뢰도 기준을 어떻게 둘지 정한 뒤 프리뷰 신청 양식을 확인한다.
Knowledge Catalog 자가학습 컨텍스트 보강, 무엇이 바뀌었나
에이전트에게 "지난달 순매출이 얼마냐"고 물었는데 엉뚱한 숫자가 나오면, 데이터 담당자는 에이전트 설명서를 열어 정의를 손으로 고치게 된다. 새로 들어온 직원이 질문을 받을 때마다 선배가 "우리 회사 순매출은 환불을 뺀 값이야"라고 메모를 덧붙여 주는 것과 비슷하다. 이번 기능은 그 메모를 에이전트의 질문과 답변 기록에서 찾아 대신 제안한다. 다만 제안이 곧바로 정답이 되는 것은 아니어서, 어디까지 자동으로 반영할지는 사람이 정해야 한다.
구글 클라우드 발표에 따르면 이 기능은 에이전트와 사용자의 상호작용을 분석해 누락됐거나 오래된 컨텍스트를 찾는다. 플레이북, 코드 저장소, 비즈니스 문서에서 검증된 정의를 가져와 재사용할 수 있는 컨텍스트 세트로 묶는다. Knowledge Catalog는 구글 문서에서 비즈니스 컨텍스트와 거버넌스를 제공하는 AI 기반 데이터 카탈로그로 설명하며, 이 문서에 따르면 2026년 4월 10일 전까지는 Dataplex Universal Catalog라는 이름이었고, API·CLI·IAM 이름은 바뀌지 않았다(이름 변경 안내). 에이전트는 MCP와 Context API로 이 카탈로그의 컨텍스트를 조회한다. 컨텍스트 세트는 마크다운과 YAML로 지식을 표현하는 개방형 명세인 Open Knowledge Format(2026년 6월 공개)을 기반으로 해서 번들을 가져오고 내보낼 수 있다.
| 기능 | 하는 일 |
|---|---|
| 자가학습 컨텍스트 보강 | 비즈니스 용어집식 정의, 테이블·컬럼 설명, 조인 관계, 골든 쿼리, 작업별 에이전트 지침을 제안한다. 제안마다 출처 인용과 신뢰도 점수가 붙는다. |
| 컨텍스트 세트 | 영업 에이전트에는 영업용, 재무 어시스턴트에는 재무용처럼 팀과 에이전트별로 정의를 나눠 연결한다. 접근은 IAM으로 관리하는데, 에이전트 권한이 다른 자원으로 번지는 문제는 AI 에이전트의 IAM 횡적 이동 점검법에서 다뤘다. |
| Knowledge Studio | 컨텍스트 그래프를 보고 자연어로 질문하며, 제안된 변경을 승인·편집·롤백한다. 보강 작업의 일정과 토큰 사용량도 본다. |
분석 대상은 제미나이 에이전트, BigQuery의 Conversational Analytics, 사용자 지정 에이전트의 상호작용 기록이다. 개인정보(PII)는 마스킹할 수 있다. 실행할 때마다 원본 문서의 변경을 감지해 더 이상 맞지 않는 정의는 폐기하고, 서로 충돌하는 정의는 검토 대상으로 표시한다.
내 경우도 해당되나: 어떤 팀이 영향을 받나
발표문이 분석 대상으로 꼽은 것은 Gemini 에이전트, BigQuery의 Conversational Analytics, 사용자 지정 에이전트의 상호작용 기록이므로, 이 중 하나를 쓰는 팀이 해당한다. 공식 문서가 말하는 컨텍스트 세트의 예처럼 같은 "순매출"이라도 조직마다 정의가 다를 수 있어서, 지표 정의가 팀마다 갈리는 곳일수록 제안을 받을 일이 많을 것이다(이 부분은 맥피의 해석이다). 반대로 구글 클라우드를 쓰지 않거나 에이전트를 데이터에 연결하지 않았다면 당장 바뀌는 것은 없다.
제공 시기는 날짜로 정해지지 않았다. 구글 클라우드는 몇 주 안에 순차 제공한다고만 했고, 바로 써 보려면 발표 페이지의 신청 양식으로 등록해야 한다. 가격과 제공 지역은 발표문에 나와 있지 않다.
자가학습 컨텍스트 보강, 지금 할 일
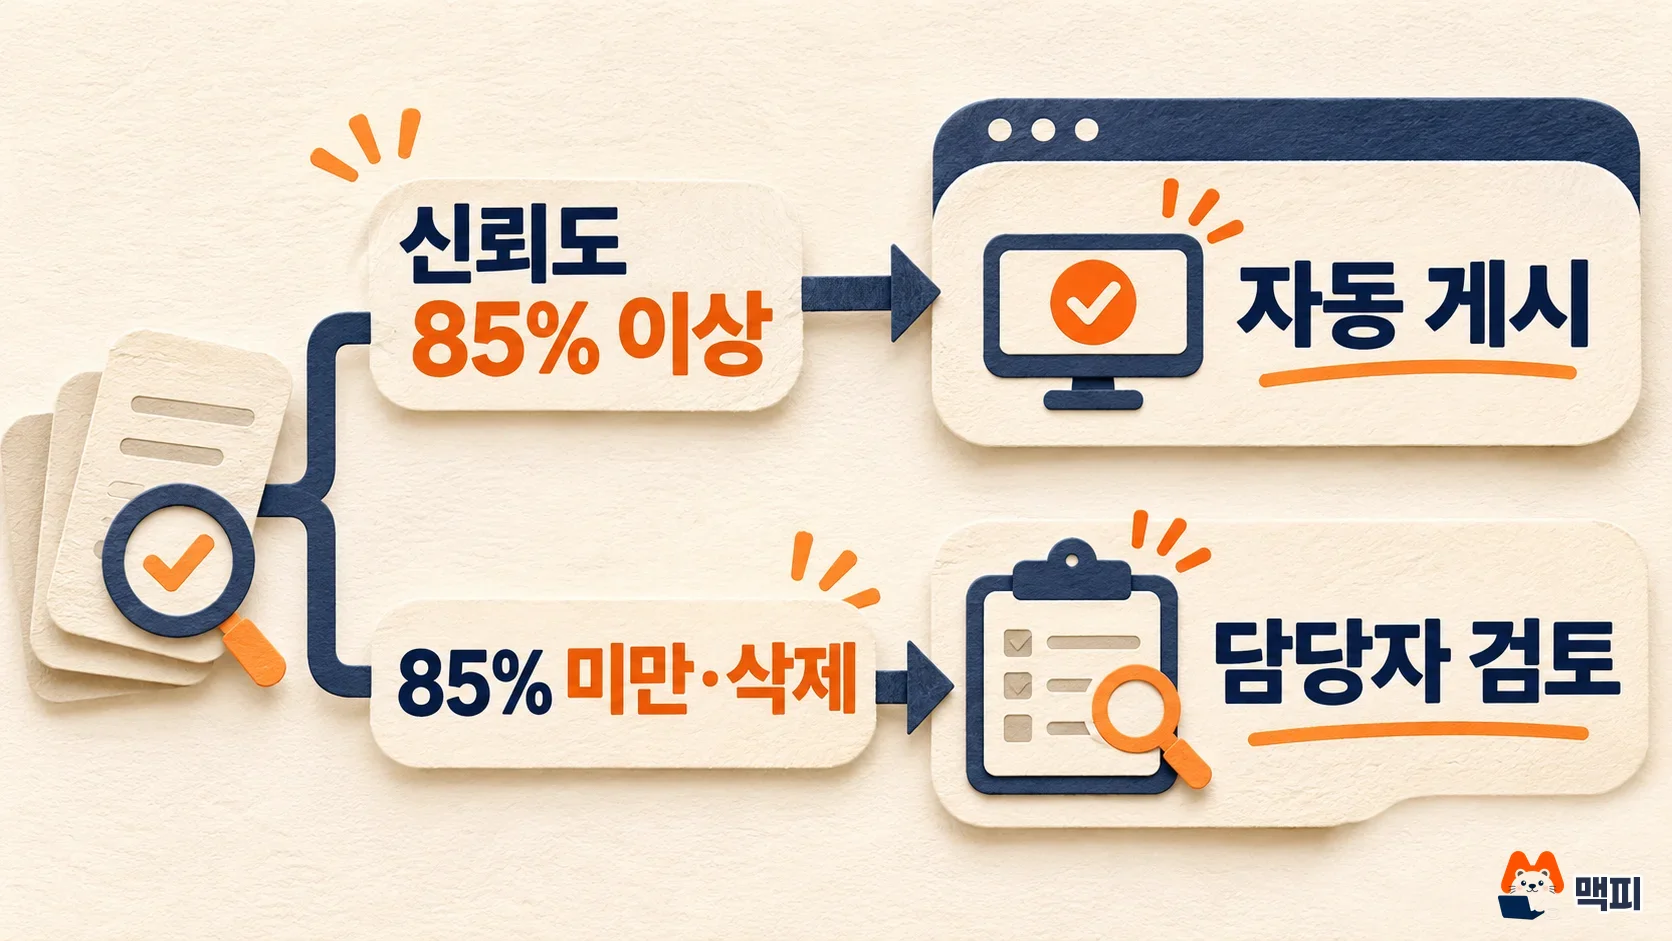
제안을 받기 전에 사람이 정해 둘 것이 있다. 발표에 따르면 자동 게시는 언제든 켜고 끌 수 있고, 자동 승인 신뢰도 기준(예시로 85%)을 직접 정한다. 기준에 못 미치는 변경과 삭제 같은 민감한 변경은 담당자가 검토하는 변경 요청(Change Request)이 된다.
아래 순서는 발표 내용을 바탕으로 한 맥피의 권고이며, 제공 전이므로 화면은 직접 확인하지 못한 상태다.
- 에이전트가 자주 틀리는 지표(순매출, 전환, 활성 사용자 등)를 적고 우리 팀의 정의를 한 줄씩 정리한다.
- 프리뷰 신청 양식으로 등록하고, 열리면 처음에는 자동 게시를 끈 채 제안을 눈으로 확인한다.
- 제안이 맞았던 비율을 보고 나서 자동 승인 기준을 정한다. 기준을 낮게 잡으면 틀린 제안도 자동으로 게시된다.
- 자체 평가 질문 세트를 만들어 둔다. 발표에 따르면 제안된 업데이트를 팀의 평가 세트로 처음부터 끝까지 시험할 수 있다.
성공 여부는 같은 질문을 제안 반영 전후에 에이전트에 던져 답이 우리 정의와 맞는지로 판단한다. Knowledge Studio에서는 변경마다 출처와 신뢰도가 기록되어 되돌릴 수 있다고 한다.
앞으로 확인할 점
구글은 발표에서 내부 벤치마크 결과로 에이전트 정확도가 약 4배 오르고 지연 시간과 토큰 사용량이 줄었다고 밝혔다. 구글 자체 측정값이므로 우리 데이터에서 같은 폭이 나온다는 뜻은 아니다.
| 지표 | 구글 발표 값 |
|---|---|
| 에이전트 정확도 | 약 4배 |
| 지연 시간 감소 | 최대 33% |
| 토큰 사용량 감소 | 최대 75% |
제공이 시작되면 가격, 지원 리전, 한국어 대화 기록을 얼마나 잘 분석하는지를 먼저 확인해야 한다. 구글은 고객 데이터로 모델을 학습시키지 않는다고도 명시했다.
같은 주제 글
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.