네이버 서치어드바이저 등록은 필수가 아니다. 2026년 10월 3일 기준으로 네이버 공식 교육자료는 네이버 검색로봇이 사이트 정보를 정상적으로 수집하면 별도 등록 없이도 검색 결과에 노출될 수 있고, 소유확인도 필수가 아니라고 안내한다. 그래도 등록하고 소유확인을 마치면 수집·노출 현황과 페이지 최적화 여부를 볼 수 있고, 사이트맵을 제출하고 수집을 요청할 수 있다. 등록한다고 검색 노출이 보장되지는 않는다.
네이버 서치어드바이저 등록은 필수일까
네이버는 웹 검색 시작하기 교육자료에서 웹마스터도구 등록이 필수가 아니라고 밝힌다. 웹마스터도구는 서비스 이름이 바뀌어 지금은 서치어드바이저(searchadvisor.naver.com)라고 부른다. 서치어드바이저는 검색로봇에 내 사이트를 알리는 창구이자, 수집에 문제가 없는지 확인하는 진단 도구다. 이 안내는 시행일이 있는 변경이 아니라 상시 운영 가이드여서 공지일이나 적용 시점이 따로 없다.
공식 문서가 등록을 권하는 것은 아니고, 아래는 이 글의 판단이다. 새로 만든 사이트나 글이 검색에 잘 안 잡히는 사이트라면 등록해 둘 만하다. 검색로봇이 사이트를 아직 발견하지 못했거나 수집을 막는 설정이 있어도, 소유확인 전에는 서치어드바이저에서 수집·노출 현황과 페이지 최적화 정보를 볼 수 없기 때문이다.
서치어드바이저는 네이버 검색 전용이다. 구글 검색 노출은 구글 서치 콘솔에서 따로 관리한다.
서치어드바이저 사이트 등록 방법 3단계
사이트 등록은 주소 입력, 소유확인, 사이트맵 제출 순서로 한다. 등록 전에 아래 점검 절의 네 가지부터 확인해 둔다.
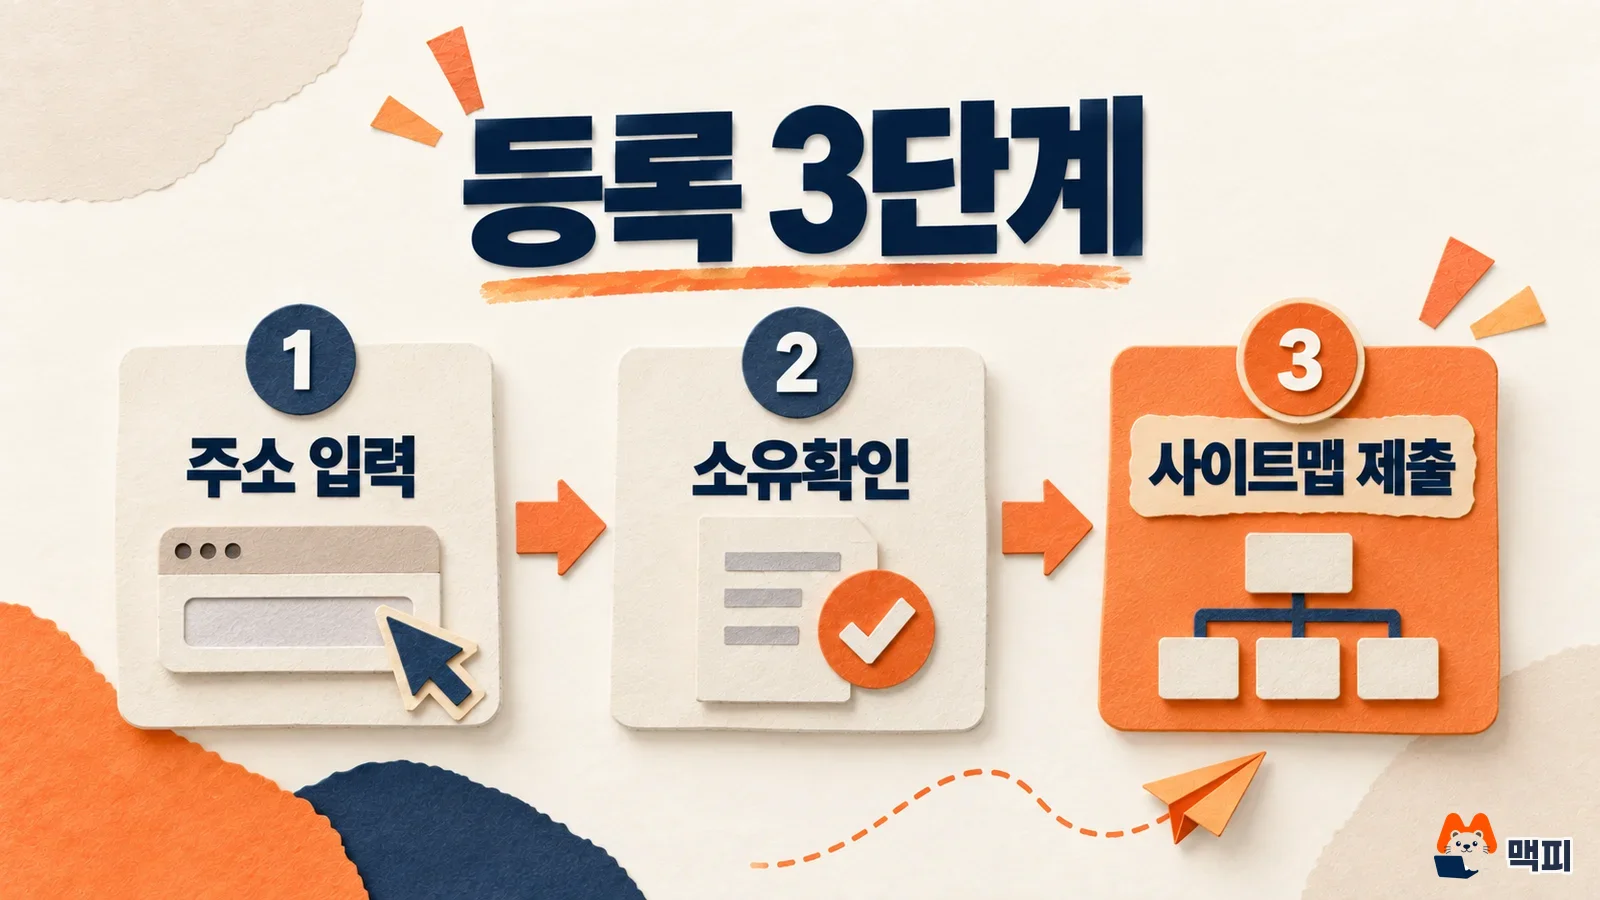
- 서치어드바이저에 로그인해 사이트 주소를 입력한다. 네이버는 같은 내용을 여러 주소로 열지 말고 대표 주소 하나만 쓰라고 안내하므로, https와 www 여부까지 정한 대표 주소를 등록한다.
- 소유확인을 한다. 방법은 다음 절에서 설명한다.
- 소유확인이 끝난 사이트를 눌러 요청 메뉴의 사이트맵 제출에서 사이트맵 주소를 낸다. 조건은 사이트맵 절에 있다.
교육자료에 따르면 소유확인 없이 사이트 등록만 마칠 수도 있다. 다만 수집·노출 현황과 페이지 최적화 정보는 소유확인을 마친 사이트에서 볼 수 있으니, 진단과 사이트맵 제출까지 쓰려면 소유확인이 필요하다.
서치어드바이저 소유확인 방법: HTML 파일과 HTML 태그
서치어드바이저 소유확인은 이 사이트가 내 것임을 네이버에 증명하는 절차이고, 방법은 네이버 교육자료가 안내하는 HTML 파일 업로드와 HTML 태그 두 가지다.
| 방법 | 하는 일 | 적합한 경우(필자 정리) |
|---|---|---|
| HTML 파일 업로드 | 서치어드바이저가 주는 확인용 파일을 사이트 루트에 올린다 | 서버나 호스팅에 파일을 직접 올릴 수 있을 때 |
| HTML 태그 | 서치어드바이저가 주는 meta 태그를 사이트 메인 페이지의 head 안에 넣는다 | 파일 업로드가 어렵고 head를 고칠 수 있을 때 |
네이버는 교육자료에서 호스팅 업체에 따라 소유확인 meta 태그를 쉽게 넣도록 도와주는 곳이 있다고 안내한다. 홈페이지 제작 서비스를 쓴다면 head 코드를 직접 고치기 전에 그 서비스의 SEO 설정 화면부터 찾아본다.
또 교육자료에 따르면 서치어드바이저에서는 사이트 정보를 고칠 수 없다. 제목이나 설명 같은 사이트 정보를 바꾸려면 호스팅 업체나 개발 담당자를 통해 HTML을 수정해야 한다.
등록 전에 robots.txt·noindex·HTTPS 점검하기
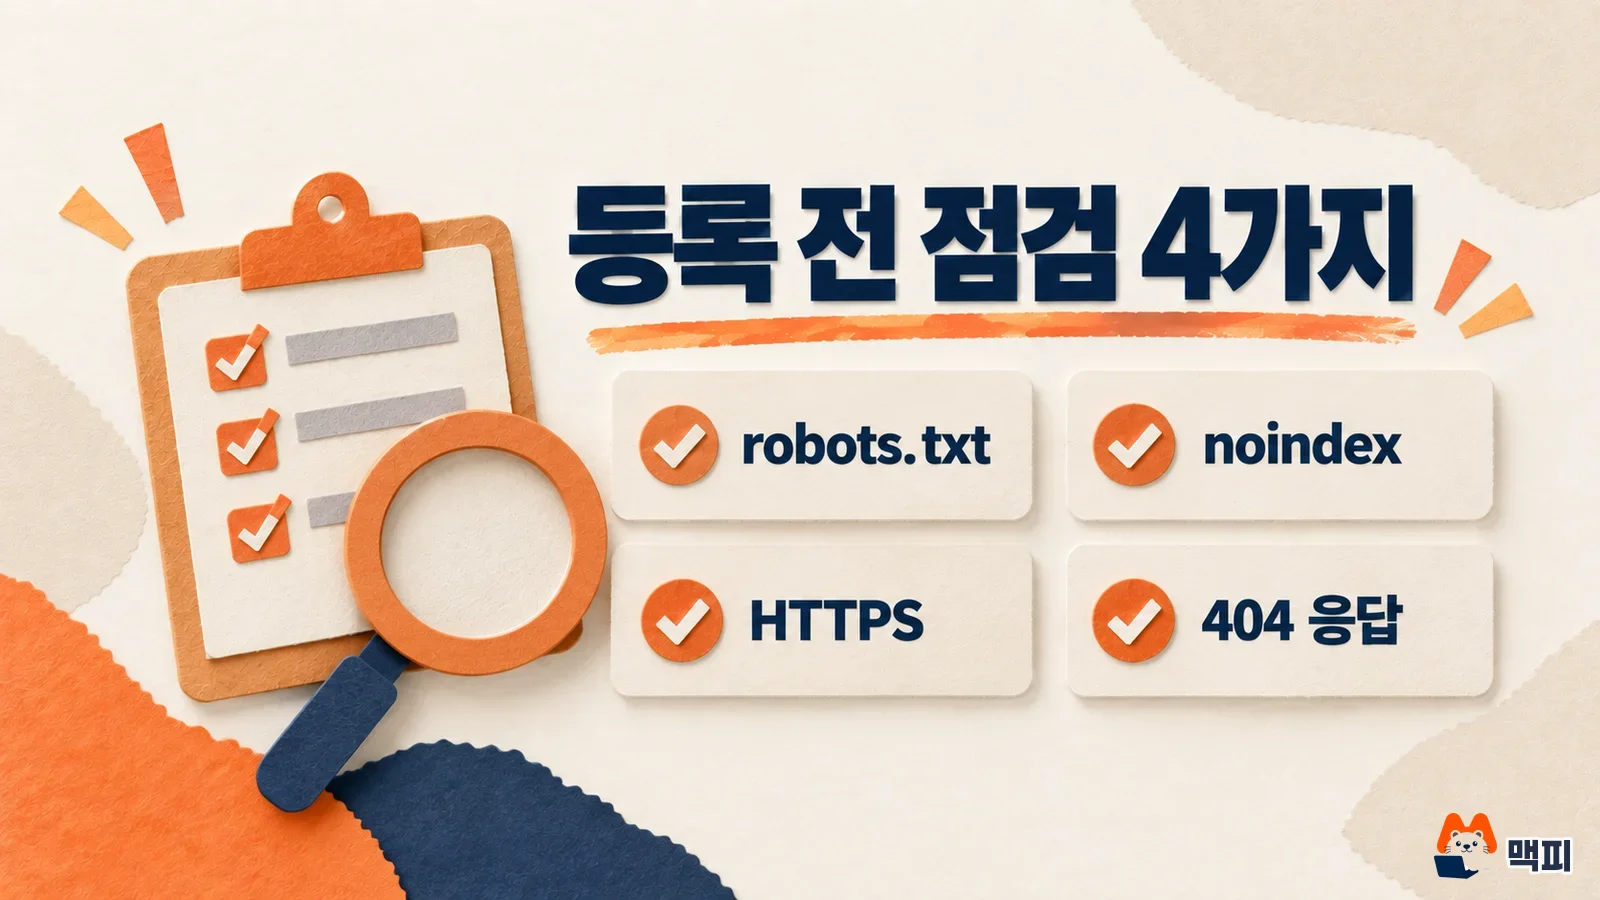
등록 전에 먼저 볼 것은 검색로봇이 사이트를 읽을 수 있는지다. 네이버 교육자료에 따르면 robots.txt 파일과 로봇 메타태그가 모두 허용으로 설정되어 있어야 검색에 노출될 수 있다. 아래 네 항목에 문제가 있으면 등록해도 수집이나 노출이 안 될 수 있다.
| 점검 항목 | 정상 상태 | 문제 상태 |
|---|---|---|
| robots.txt | 사이트 루트에 있고 text/plain으로 열린다. 네이버 검색로봇 Yeti를 막지 않는다 | User-agent: Yeti 또는 * 아래에 Disallow: /가 있다. HTML 문서로 응답하면 규칙이 없는 것(모두 허용)으로 해석될 수 있다 |
| 로봇 메타태그 | content="index"이거나 태그가 없다 | content="noindex"가 있으면 수집돼도 검색에 노출되지 않는다 |
| HTTPS 연결 | http로 들어오면 https로 리다이렉션된다 | 리다이렉션 없이 두 프로토콜을 함께 운영하면 중복 수집과 보안 문제로 불이익을 받을 수 있다. 네이버 로봇은 HTTPS를 우선 수집한다 |
| 응답 코드 | 정상 페이지는 200, 없는 페이지는 404 Not Found | "페이지가 없습니다"만 보여 주고 200 OK를 돌려주면 안 된다 |
robots.txt는 브라우저 주소창에 내사이트주소/robots.txt를 입력하면 본다. 규칙 글자만 나오면 정상이다. AI 검색 봇까지 함께 허용하거나 막으려면 AI 검색 최적화 크롤러 허용·차단 방법을 참고한다. robots.txt는 같은 호스트, 프로토콜, 포트에만 적용되어서 http와 https, www 유무마다 따로 본다. 소유확인과 별개로 교육자료가 소개하는 서치어드바이저의 사이트 간단 체크에서도 접속 여부, robots.txt, 로봇 메타태그 상태를 조회할 수 있다.
같은 내용을 여러 주소로 열어 두었다면 웹 사이트를 만들 때 가이드에 따라 대표 주소 하나로 301 리다이렉트한다. www가 있는 주소와 없는 주소도 한쪽으로 모으고, 자바스크립트가 아닌 HTTP 리다이렉트를 쓴다. 301이 어려우면 rel="canonical"로 대표 주소를 적는다.
네이버 사이트맵 제출 조건과 방법
사이트맵은 수집할 URL 목록을 담은 XML 파일이고, 서치어드바이저에서 소유확인을 마친 사이트의 요청 메뉴에서 제출한다. 네이버 RSS 및 사이트맵 제출 가이드에 따르면 제출된 사이트맵은 콘텐츠 피드로 간주되어 검색로봇이 주기적으로 다시 방문하고, 네이버 검색에서 내 콘텐츠 노출량이 적다면 제출을 권장한다.
같은 가이드에 나온, 제출할 때 서치어드바이저가 검증하는 조건은 아래와 같다.
| 항목 | 사이트맵 | RSS |
|---|---|---|
| 도메인 | 피드 안 모든 URL이 소유확인한 사이트와 같은 도메인 | 같음 |
| 용량 | 10MB 이상이면 제출 불가 | 10MB 이상이면 제출 불가 |
| 개수·내용 | 하나의 사이트맵에 URL 50,000개 이상 불가 | 글(item)이 1개 이상, 각 글의 본문 전체 공개 |
| 응답 속도 | 수집 때 응답이 느리면 제출이 제한될 수 있음 | 같음 |
네이버는 제출 가이드에서 RSS가 본문까지 담아 URL을 많이 넣기 어렵다는 이유로 RSS보다 사이트맵을 적극 활용하라고 권한다. URL이 많아 하나로 담기 어려우면 사이트맵 인덱스로 여러 사이트맵을 묶는다.
robots.txt에 Sitemap: https://내사이트주소/sitemap.xml 한 줄을 적어 사이트맵 위치를 알릴 수도 있다. 사이트 상태 리포트는 서치어드바이저로 등록하지 않았어도 robots.txt에서 사이트맵이 확인되면 이를 정상으로 표시한다.
제출한 뒤에는 사이트 상태의 사이트맵 항목이 "사이트맵이 등록되었습니다"인지 본다. 사이트 상태는 1~2일 주기로 갱신된다. "사이트맵을 찾을 수 없습니다"로 나오면 서치어드바이저로 등록했지만 사이트맵 주소가 200 OK로 열리지 않는다는 뜻이므로, 주소를 브라우저로 직접 열어 본다.
수집요청은 언제 쓰고 얼마나 걸리나
수집요청은 검색로봇이 아직 방문하지 못한 주요 페이지의 URL을 네이버 수집 시스템에 전달하는 기능이고, 요청 메뉴의 페이지 수집에서 한다. 수집요청 및 검색제외 가이드에 따르면 요청한 URL은 우선순위에 따라 처리되어 최소 1일에서 몇 주가 걸릴 수 있다. 그래서 같은 URL을 매일 반복해서 요청할 필요가 없다.
같은 가이드에 따르면 수집요청 기능은 사이트별로 제한된 범위에서 쓸 수 있고, 스팸으로 판단되는 사이트의 요청은 제한될 수 있다. 네이버는 인위적인 요청보다 검색로봇의 자연스러운 수집을 권장한다. 이 글의 판단으로는 새 글을 올릴 때마다 요청하기보다 사이트맵을 갱신해 두고 급히 알리고 싶은 페이지에만 요청하는 쪽이 이 안내의 취지에 맞다.
검색에서 지우고 싶은 페이지는 순서가 있다. 수집요청 및 검색제외 가이드의 순서는 이렇다. 먼저 사이트의 원본을 삭제하고, 검증 메뉴의 웹페이지 최적화에서 삭제된 문서가 404 Not Found를 돌려주는지 확인한다. 그다음 요청 메뉴의 웹 페이지 검색 제외에 해당 URL을 넣는다. 재색인을 거치므로 검색 결과에서는 바로 사라지지 않는다.
자주 하는 실수
- 등록하면 검색 상위에 뜬다고 기대한다. 등록은 로봇에게 사이트를 알리는 일이고, 수집에 성공해도 노출은 보장되지 않는다.
- robots.txt를 HTML 페이지로 응답시킨다. robots.txt 가이드에 따르면 규칙을 적어도 없는 것으로 해석되어 막으려던 페이지가 열릴 수 있다. text/plain으로 응답하게 한다.
- 개인정보 페이지를 robots.txt로만 막는다. 같은 가이드에 따르면 광고주 정보 취득이나 링크 미리보기 같은 특수 로봇은 규칙을 따르지 않을 수 있으니, 외부에 보이면 안 되는 페이지는 로그인으로 보호한다.
- 사이트 제목과 설명을 비우거나 같게 쓰고, 내용과 관련 없는 키워드를 나열한다. 네이버 교육자료는 이런 경우 노출에 불이익이 있을 수 있다고 안내하며, 제목은 15자 이내, 설명은 45자 이내를 권장한다. 이 길이 권장은 사이트 검색 따라 하기 부분의 팁이다.
- 원본을 지우기 전에 검색 제외를 요청한다. 순서는 원본 삭제, 404 응답 확인, 검색 제외 요청이다.
자주 묻는 질문
robots.txt를 고친 뒤 네이버에 바로 알릴 수 있나
robots.txt 설정 가이드에 따르면 서치어드바이저의 robots.txt 도구에서 수집 요청을 누르면 수정한 파일을 검색로봇에 빠르게 알릴 수 있다. 같은 도구에서 규칙이 적용된 URL이 수집 가능한지 테스트도 한다.
서치어드바이저에 등록하면 구글에도 등록되나
아니다. 서치어드바이저는 네이버 검색 전용이어서 구글은 서치 콘솔에서 따로 등록해야 한다.
사이트맵을 robots.txt에 적었는데 서치어드바이저에 또 내야 하나
robots.txt에서 확인되면 사이트 상태 리포트가 사이트맵을 확인했다고 표시한다. 서치어드바이저에서 따로 제출하면 제출 시점에 도메인, 용량, URL 수 검증을 받는다.
오늘 할 일은 브라우저에서 내사이트주소/robots.txt를 열어 Yeti가 막혀 있지 않은지 확인하고, 대표 주소로 서치어드바이저에 사이트를 등록하는 것이다.
출처: 네이버 서치어드바이저 RSS 및 사이트맵 제출, 수집요청 및 검색제외, robots.txt 설정하기, 웹 사이트를 만들 때, 사이트 상태, 웹 검색 시작하기 교육자료(PDF). 2026년 10월 3일 확인. 이미지는 설명용 생성 일러스트이며 실제 서치어드바이저 화면이 아니다.
같은 주제 글
이 글이 도움이 되었다면 공유해주세요
최신 인사이트
카카오톡 공유 썸네일 안 나올 때 해결법 (Kakao JavaScript SDK 2025)
카카오톡 공유하기에서 썸네일 이미지가 안 나오는 원인과 scrapImage로 KAGE URL을 변환해 해결하는 방법을 단계별로 설명합니다. 지금 확인하세요.
Claude Code 서브에이전트로 CRM 사용자 설명서 20분 만에 완성하는 방법
Claude Code 서브에이전트를 활용해 CRM 코드베이스에서 사용자 설명서와 비주얼 가이드북을 20분 만에 자동 생성한 실전 사례를 공유합니다. 지금 확인하세요.
GEO 생성형 엔진 최적화: 2025년 AI 마케팅 전략 완전 가이드
GEO 생성형 엔진 최적화란 무엇이며 기존 SEO와 어떻게 다른지, 2025년 AI 마케팅 전략의 핵심 실행 방법 5가지를 데이터와 함께 알아보세요.
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.