2026년 10월 1일 기준으로, AI 검색 최적화(GEO)는 robots.txt에서 검색용 봇을 허용하고 학습용 봇만 따로 정하면 된다. 구글은 AI 개요와 AI 모드에 노출되려고 따로 할 일이 없다고 공식 문서에 적었다. 챗GPT·퍼플렉시티·클로드는 회사마다 봇 이름이 다르다. OpenAI와 구글은 학습용 봇을 막아도 검색 노출과는 별개라고 밝혔다.
구글은 AI 검색용으로 따로 할 일이 없다
구글 공식 문서는 AI 개요와 AI 모드에 나오기 위한 추가 요건이나 특별한 최적화가 필요 없다고 밝힌다. AI 전용 마크업이나 파일을 만들 필요도 없다. 페이지가 구글 검색에 색인되어 있고 스니펫(검색 결과에 보이는 발췌문)을 보여 줄 자격이 있으면 된다. 이 문서는 2025년 12월 10일에 마지막으로 갱신됐다.
AI 답변에 내 글이 어떻게 쓰이는지는 기존 검색 설정으로 조절한다. nosnippet, max-snippet, noindex 같은 메타 태그가 그대로 적용된다. 노출 성과는 서치 콘솔 성능 보고서의 '웹' 검색 유형에서 함께 잡힌다.
맥피는 이 문서를 근거로 구글용 GEO 작업을 따로 만들지 않는다. 색인과 스니펫이 정상인지부터 본다. 이 글은 크롤러 허용과 차단만 다룬다. OpenAI도 허용하면 검색 결과에 나타날 가능성이 높아진다고만 안내한다. 허용이 노출을 보장하지는 않는다.
AI 봇은 세 종류로 나눠 본다
크롤러는 웹페이지를 읽어 가는 자동 프로그램이다. AI 회사는 목적별로 봇을 나눠 운영한다. 목적을 알아야 허용과 차단을 고를 수 있다.
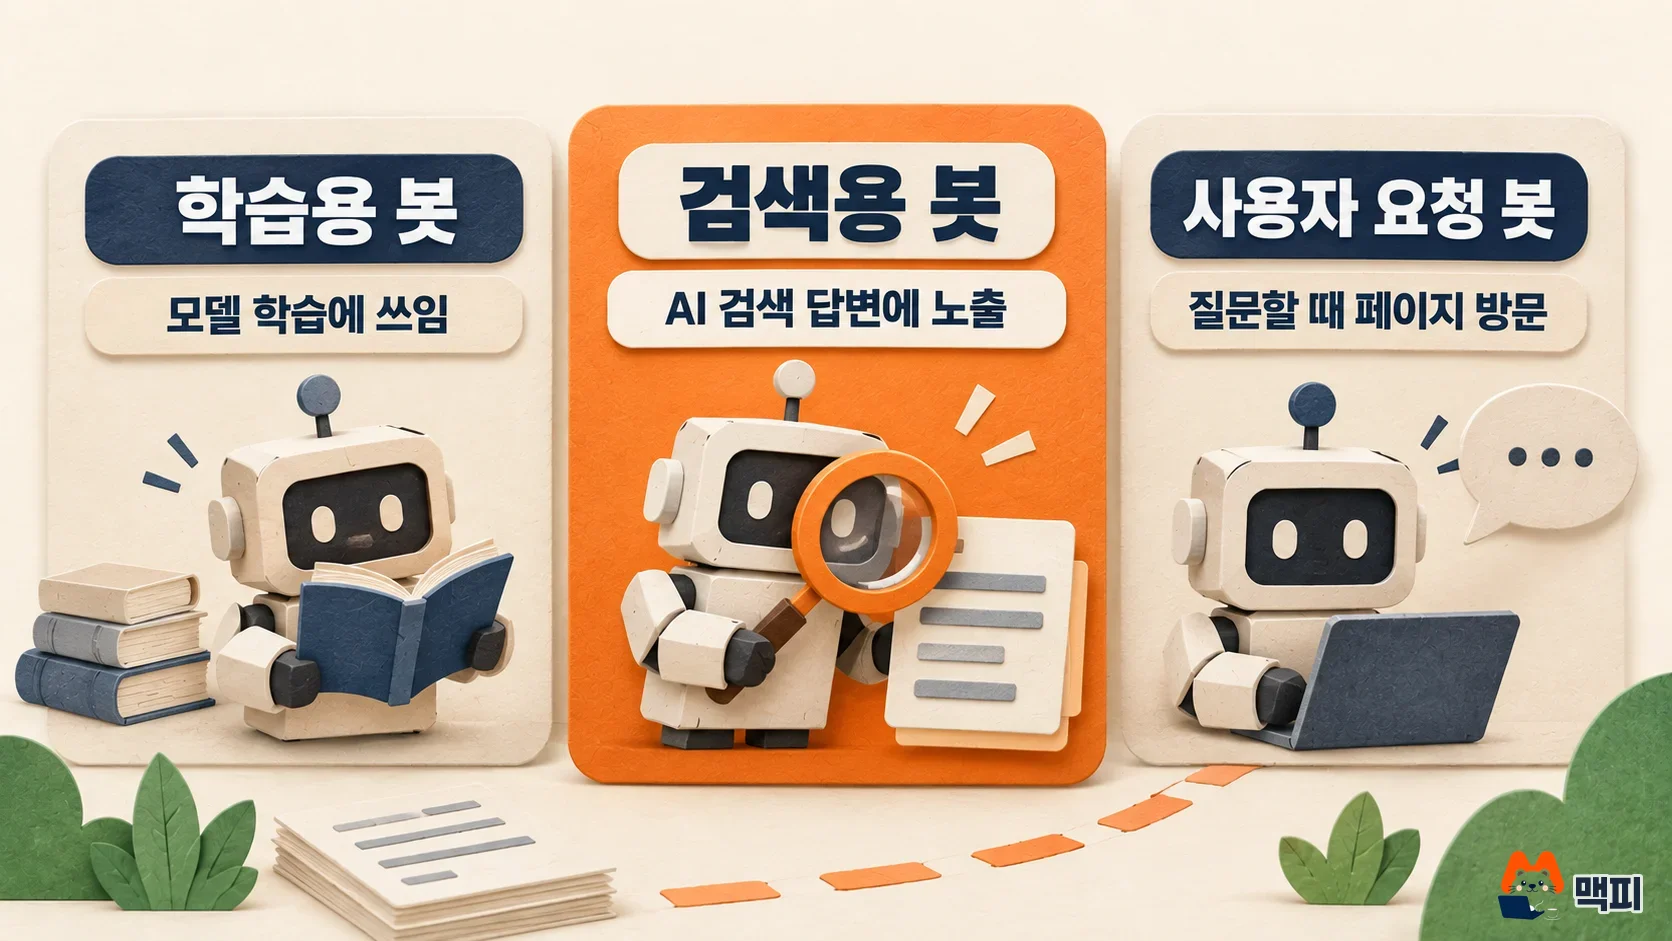
- 학습용 봇: 모델을 학습시키려고 글을 모은다. OpenAI와 구글 문서 기준으로 막아도 검색 노출과는 별개다.
- 검색용 봇: AI 검색 결과에 내 사이트를 보여 주려고 글을 모은다. 막으면 그 서비스의 검색 답변에서 빠지거나 줄어든다.
- 사용자 요청 봇: 사용자가 "이 페이지 읽어 줘"라고 시킬 때 그 순간에만 페이지를 방문한다.
회사별 봇 이름과 막았을 때 생기는 일
robots.txt는 사이트 맨 위 주소(예: example.com/robots.txt)에 두는 출입 안내문이다. 봇은 자기 이름이 적힌 칸을 찾아 허용인지 차단인지 읽는다. 아래 표의 이름을 그대로 써야 한다.
| 회사 | robots.txt 이름 | 하는 일 | 막으면 |
|---|---|---|---|
| OpenAI | OAI-SearchBot | 챗GPT 검색 결과에 사이트 노출 | 챗GPT 검색 답변에 나오지 않는다. 변경 반영에 약 24시간이 걸린다 |
| OpenAI | GPTBot | 모델 학습용 수집 | 학습에 쓰이지 않는다. 검색 노출과는 별개다 |
| OpenAI | ChatGPT-User | 사용자가 시킬 때 페이지 방문 | 사용자 요청 방문이라 robots.txt 규칙이 적용되지 않을 수 있다 |
| 퍼플렉시티 | PerplexityBot | 퍼플렉시티 검색 결과에 사이트 노출 | 검색 결과에 나오려면 허용해야 한다. 학습에는 쓰지 않는다고 밝혔다 |
| 퍼플렉시티 | Perplexity-User | 사용자 질문에 답하려고 페이지 방문 | 대체로 robots.txt를 따르지 않는다고 밝혔다 |
| 앤트로픽(클로드) | ClaudeBot | 모델 학습용 수집 | 앞으로 올리는 글이 학습 데이터에서 빠진다 |
| 앤트로픽(클로드) | Claude-SearchBot | 검색 결과 품질을 높이려는 색인 | 검색 결과에서 노출이 줄 수 있다 |
| 앤트로픽(클로드) | Claude-User | 사용자가 클로드에 물을 때 방문 | 사용자 질문 중 접근이 막혀 노출이 줄 수 있다 |
| 구글 | Google-Extended | Gemini 모델 학습 사용 여부를 정하는 토큰 | 구글 검색 포함과 순위에는 영향이 없다 |
출처는 각 회사의 공식 문서다: OpenAI 봇 문서, 퍼플렉시티 봇 문서, 앤트로픽 크롤러 안내, 구글 크롤러 문서. 표의 내용은 모두 2026년 10월 1일에 이 문서들에서 확인한 것이다. 맥피는 이 표에 AI 검색 최적화 효과를 숫자로 넣지 않았다. 공식 문서에 근거가 없기 때문이다.
복사해 쓰는 robots.txt 예시
검색 노출은 유지하면서 학습 사용만 막고 싶을 때 쓰는 조합이다. 순서는 세 단계다.
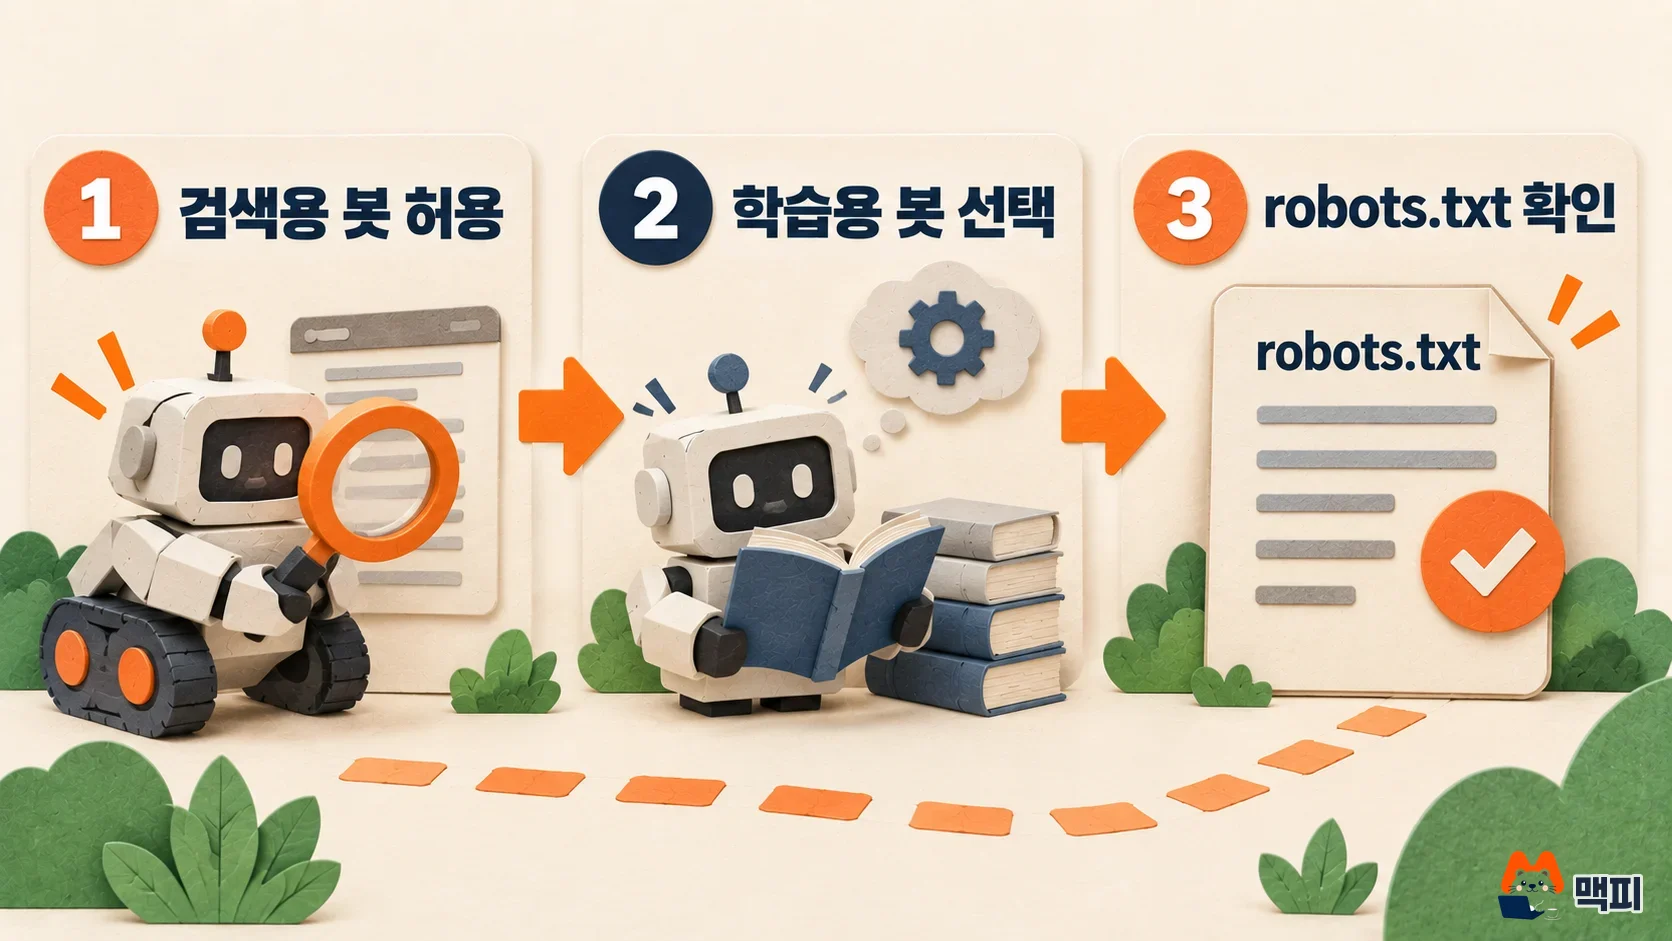
- 검색용 봇(OAI-SearchBot, PerplexityBot, Claude-SearchBot)을 허용한다.
- 학습용 봇(GPTBot, ClaudeBot, Google-Extended)은 사이트 방침대로 정한다.
- 저장한 뒤 내 주소의
/robots.txt를 열어 확인한다.
검색 노출을 우선하는 사이트라면 맥피는 아래 조합을 권한다. 공식 문서의 권고가 아니라 맥피의 판단이다. 이름은 위 표와 같은 철자로 적었다.
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
학습용 봇을 막을지는 사이트 방침으로 정한다. 학습을 허용하려면 해당 칸을 지우거나 Allow: /로 바꾼다. 사용자 요청 봇은 예시에 넣지 않았다. 따로 적지 않으면 차단하지 않은 상태다.
이미 User-agent: * 칸에 Disallow: /가 있으면 이름을 적지 않은 봇은 모두 막힌다. 위 예시처럼 허용할 봇의 이름을 따로 적어야 한다.
한국 사이트가 확인할 점
한국 검색 유입은 네이버를 빼놓을 수 없다. 네이버 서치어드바이저 안내에 따르면 네이버 검색로봇은 Yeti이고, robots.txt에 적힌 규칙을 따른다. 사이트 루트에 robots.txt가 없으면 모든 콘텐츠를 수집해도 된다고 본다.
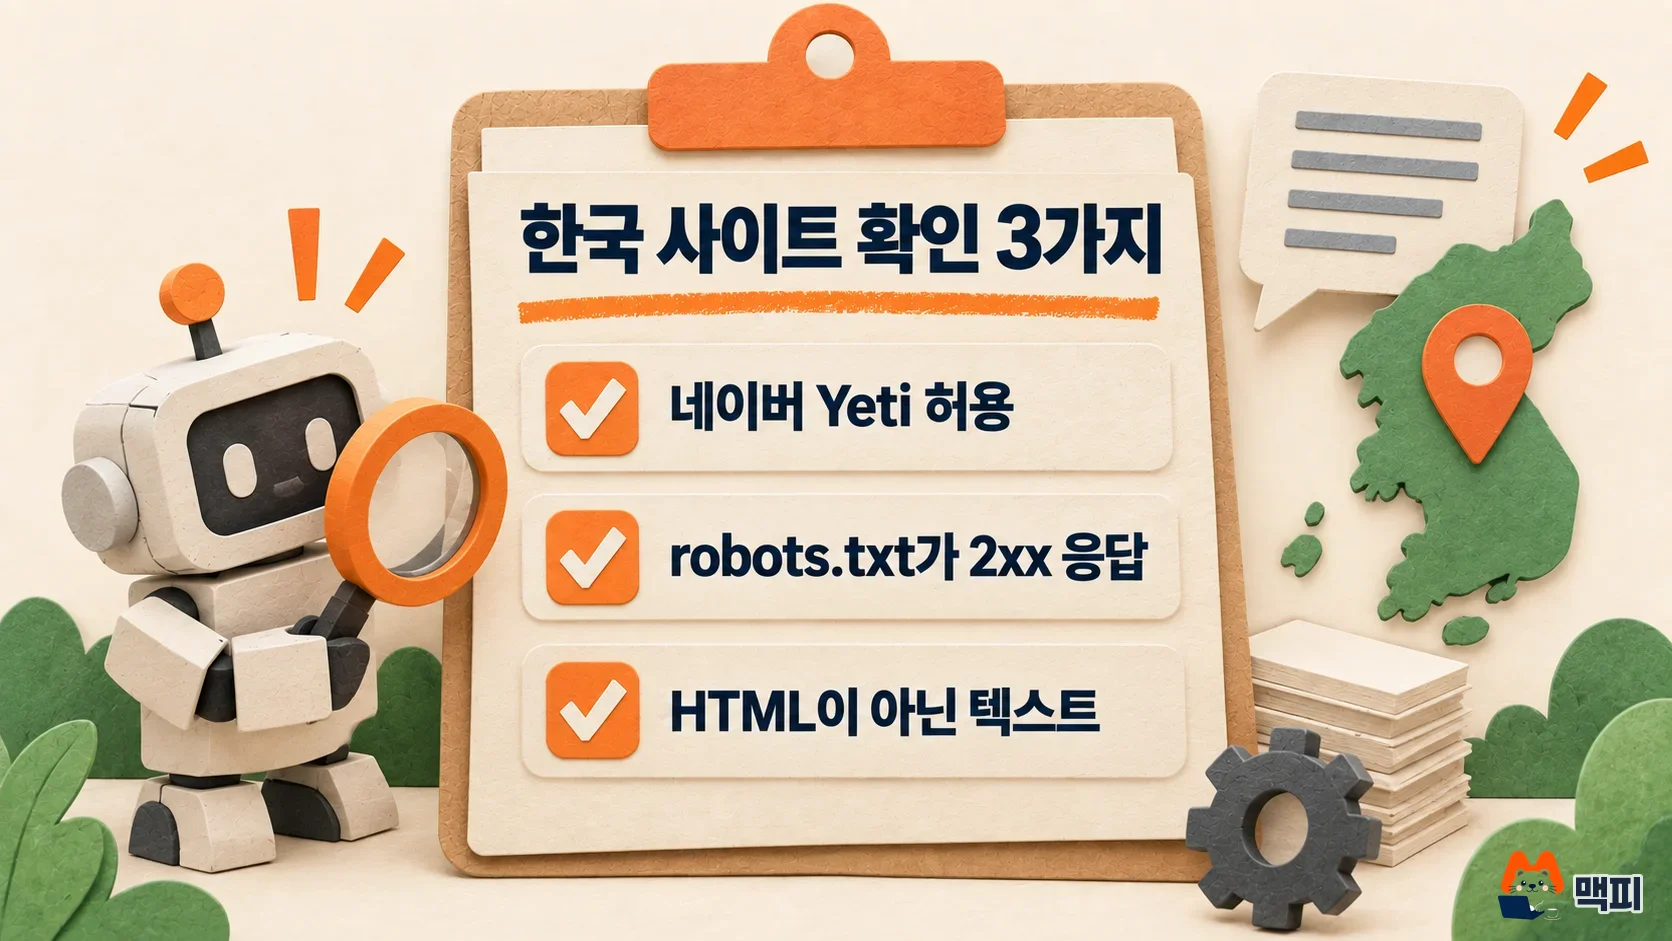
안내에 나온 확인 항목은 세 가지다.
- Yeti를 허용한다:
User-agent: Yeti칸이 차단으로 되어 있지 않아야 한다. - robots.txt가 정상 응답(2xx)을 준다: 로봇이 파일을 읽을 수 있어야 규칙이 적용된다.
- 텍스트 파일로 내려준다: HTML 문서로 돌려주면 유효한 규칙이 있어도 "robots.txt 없음"으로 해석될 수 있다.
robots.txt 주소가 일반 웹페이지(HTML)를 돌려주는 경우가 있다. 브라우저로 내 주소의 /robots.txt를 열어 규칙 글자만 나오는지 본다. 자세한 설정은 네이버 서치어드바이저 robots.txt 가이드에 있다.
자주 하는 실수
- 학습용 봇을 막으면 AI 검색에서도 빠진다고 생각한다. OpenAI 문서는 GPTBot이 학습용이고 검색 노출은 OAI-SearchBot이 맡는다고 구분한다. 구글도 Google-Extended가 검색 포함에 영향이 없다고 밝혔다.
- robots.txt가 모든 방문을 막아 준다고 믿는다. 사용자 요청 봇은 회사에 따라 규칙을 따르지 않을 수 있다. 외부에 나가면 안 되는 글은 로그인 같은 다른 방법으로 지킨다.
- 구글 AI 개요용 파일이나 마크업을 따로 만든다. 공식 문서는 필요 없다고 한다.
- 바꾼 직후 결과를 기대한다. OpenAI는 OAI-SearchBot 설정 반영에 약 24시간이 걸린다고 안내한다.
자주 묻는 질문
GEO 최적화와 기존 SEO는 다른 작업인가
맥피는 구글 기준으로 같은 작업으로 본다. 구글 문서가 AI 개요에 나오는 데 추가 요건이 없다고 밝히기 때문이다. 색인과 스니펫이 정상이면 AI 개요에 나올 조건을 갖춘 것이다. 챗GPT·퍼플렉시티·클로드는 각 회사의 검색용 봇이 읽을 수 있는지가 첫 조건이다.
사용자 요청 봇은 허용해야 하나
따로 차단하지 않으면 허용 상태다. 앤트로픽은 Claude-User를 막으면 사용자 질문 중 접근이 막혀 노출이 줄 수 있다고 안내한다.
오늘 할 일은 하나다. 내 사이트의 /robots.txt를 열어 OAI-SearchBot, PerplexityBot, Claude-SearchBot, Yeti가 막혀 있지 않은지 확인한다.
같은 주제 글
이 글이 도움이 되었다면 공유해주세요
관련 인사이트
관련 프로젝트
새 글을 이메일로 받아보세요
마케팅, 분석, 개발 인사이트를 정리해서 보내드려요.